页面

2012年6月24日星期日

【外刊IT评论网】坐得越久 死得越快

【外刊IT评论网】坐得越久 死得越快: 又一项研究显示,久坐对你的健康是真的、真的、真的非常有害。请买一个可站着工作的桌子吧! [caption id="attachment_4146" align="aligncenter" width="478" caption="可站着编程的电脑桌"]可站着编程的电脑桌[/caption]
一项对超过20万个澳大利亚人的研究结果给这样一个事实又增加了一份活体证明:坐得越久的人死得越快。研究同时还发现,锻炼不能改变这种趋势——尽管它能有效降低这种风险。
研究结果清晰的告诉我们这样一个简单的信息:多站立、少坐着,这样能延长你的寿命。
尽管那些每周锻炼超过5个小时的人的死亡风险会大大降低,但当他们坐的过久时,这种风险仍然会升高。
目前,“久坐对身体有害”已经被广泛的认可。最近几年的研究表明,在电脑屏幕前、电视前做得太久,或仅是闲坐太久,都会增加你死亡的风险。
这次的调查采取了一种更直接的方式,观察人们每日坐着的时间总和和他们在之后三年内死亡率之间的关系,希望能给久坐的危害程度标个数字。
结果让人震惊,每天坐着超过11小时的人在未来三年的死亡风险要比每天坐着少于4小时的人的死亡风险高出40%。这是经过了对年龄、体重、物理锻炼、健康水平等所有会影响到死亡风险的因素进行校正后得到的结果。同时得到的一个正比数据是:坐得越久,死亡风险越高。
这个研究是萨克斯研究所(Sax Institute)的45 and Up研究项目的组成部分。45 and Up Study是南半球目前最大的真正进行的关于健康衰老研究项目。研究数据来自222497个超过45岁的澳大利亚人每天自主报告的总计坐的时间。研究者拿这些数据跟他们在之后三年的死亡率进行了对比。
不管他们健康还是有病,喜欢运动还是不爱运动,他们坐得越久,在未来三年里的死亡风险就会越高。锻炼可以大量的降低这种风险:坐的最久的人比坐的很少的人的死亡风险只高出40%,但拿坐的最久且锻炼最少的人和坐的很少但锻炼最多的对比,这个数字会变成100%。尽管每周锻炼超过5小时的人的风险会低很多,但当他们做的太久时,风险度仍是往上走的。
换句话说就是,你需要去锻炼,但同等重要的事是,尽量少坐。
有一篇社论曾建议说,证据已经如此丰富,我们的大夫完全应该在给病人的处方中建议他们减少坐着的时间。但我们自己为什么不能主动行动,给自己开出这样的药方呢。
据粗略统计,人们在休闲时90%以上的时间是坐着的。所以,我们还有很大改善的空间。

本文来自外刊IT评论网(www.aqee.net),原始地址:坐得越久 死得越快


2012年6月18日星期一

初学者程序语言的选择


小小才子 通过 Google 阅读器发送给您的内容:


于 12-5-24 通过 当然我在扯淡 作者:王垠

很多人都关心这个问题,来信问我。我一直想总结一下经验,今天终于开始写这篇文章。我的文章一般都会在发表之后有所改动,所以如果转载请只给出链接,以便得到最新的版本。


面向对象语言不适合入门

有的人抱怨很多学校开始教授 Java 而不是以前的 C 或者 Pascal。的确,Java 有很多问题,使得它不适合作为一种入门语言。其实 Java 本质上是把自身的一种古板的设计强加于程序员,使得他们失去了灵活的思维。比如 Java 缺少高阶函数,也就是不能把函数作为参数或者变量传递,这导致了需要使用繁琐的设计模式 (design patterns) 来达到甚至对于 C 语言都直接了当的事情。

Java 在教学中的过度使用,已经开始引起对整个业界的负面作用。很多公司里的程序员喜欢生搬硬套一些不必要的设计模式,其实什么好事情也没干,只是使得程序冗长难懂。我从来不用通常所谓的设计模式,即使我需要实现一些模式比如 visitor pattern 的功能,我也是用的自己的设计。你完全可以在 Java 语言里达到 visitor 的实际效果,却不使用通常所谓的 visitor。这个我以后可能详细说一下。但是我的方法虽然比普通的办法好,也只能算是一个变通方案 (workaround)。在这里,我只是要说,Java 不适合初学者,因为初学者不应该学习变通方案。这些变通并不是在所有语言里都需要的。教会他们这些东西,只会让他们对错误的思想记忆更加深刻,从而在将来的设计中犯同样的错误,导致恶性循环。比如我在某些人写的 Lisp 程序里面居然看到 visitor pattern,真是哭笑不得。本来是因为一个语言有毛病所以我们使用变通方案,但是这种变通居然被用到了本来没有这毛病的语言身上!

那么除了 Java,是否可以考虑具备高阶函数的 Python,JavaScript,Ruby,Scala,Clojure 这些语言呢?我不否认它们的实用价值,但是作为初学编程的人,它们不是很好的选择。因为这些语言的设计者,并不是最好的程序语言专家,他们有时候甚至不明白一些最基本的概念。以至于这些语言里面的很多东西,虽然起着响亮的名字,却并没有"地道"的实现。比如 Python 也有 lambda,但是 Python 的 lambda 是一个被阉割的 lambda,它并没有 lambda 完整的功能,以至于它只能被用于最简单的地方。这就是为什么 Guido van Rossum 曾经扬言要把 lambda 从 Python3 里去掉,因为他自己都不懂得 lambda 是什么。Python 还有别的别的一些明显糟糕的设计,却直到 Python3 才部分的被 Guido 觉悟到。我实现过 Python 的类型推导,所以我知道这些设计的幼稚可笑。不要小看这个类型推导,它是基于一个先进的概念叫"抽象解释"(abstract interpretation),为此我基本上实现了整个 Python 的语义。在摸索 Python 语义的过程中,我很惊讶的发现,有时候我会在某些语义概念上"不小心"做出正确的选择,而到头来我却需要把它们改成错误的,否则我无法准确的符合 Python 的语义。其它几个语言也有类似的问题,但是恐怕只有当你领会到函数式语言的真谛之后才会明白。比如,精通 Haskell 的人都会发现用 Scala 其实非常折腾。

我多次的想写一篇关于面向对象语言的毛病的文章,到头来却发现很难下笔。这就像听惯了巴赫的音乐之后,再让你去评论流行音乐有什么毛病。你根本说不清楚,因为没有体会过真正的杰作的人,他们不会理解你说的任何理由。你只能轻描淡写的让他们去尝试,去体验。到头来如果他们体会到了,听到流行音乐就会恍然大悟的发现,它们原来是如此的苍白无趣,味同嚼蜡!但是如果他们不能体会到,那也只能由他们去了。


底层语言不适合入门

那么是否 C 就会好一些呢?其实也不是。很多人推崇 C,因为它可以让人接近"底层",也就是接近机器的表示,这样就意味着它速度很快。这里其实有三个问题:

  1. 接近"底层"是否对于初学者是好事?
  2. "速度快的语言"是什么意思?
  3. 接近底层的语言是否一定速度快?

对于第一个问题,我的答案是否定的。其实编程最重要的思想是高层的语义(semantics)。语义构成了人关心的问题以及解决它们的算法。而具体的实现(implementation)比如一个整数用几个字节表示,虽然还是重要,但却不是至关重要的。如果把实现作为学习的主要目标,就本末倒置了。因为实现是可以改变的,而它们所表达的本质却不会变。所以很多人发现自己学会的东西,过不了多久就"过时"了。那就是因为他们学习的不是本质,而只是具体的实现。

其次,谈语言的"速度",其实是一句空话。语言只负责描述一个程序,而程序运行的速度,其实绝大部分不取决于语言。它主要取决于 1)算法 和 2)编译器的质量。编译器和语言基本是两码事。同一个语言可以有很多不同的编译器实现,每个编译器生成的代码质量都可能不同,所以你没法说"A 语言比 B 语言快"。你只能说"A 语言的 X 编译器生成的代码,比 B 语言的 Y 编译器生成的代码高效"。这几乎等于什么也没说,因为 B 语言可能会有别的编译器,使得它生成更快的代码。

我举个例子吧。在历史上,Lisp 语言享有"龟速"的美名。有人说"Lisp 程序员知道每个东西的值,却不知道任何事情的代价",讲的就是这个事情。但这已经是很久远的事情了,现代的 Lisp 系统能编译出非常高效的代码。比如商业的 Chez Scheme 编译器,能在5秒钟之内编译它自己,编译生成的目标代码非常高效。它的实现真的令人惊叹,因为它的作者 R. Kent Dybvig 几乎不依赖于任何已有的软件和设计。这个编译器从最初的 parser,到宏扩展,语义分析,寄存器分配,各种优化,…… 一直到汇编器,函数库,全都是他一个人写的。它可以直接把 Scheme 程序编译到多种处理器的机器指令,而不通过任何第三方软件。它内部的一些算法,其实比开源的 LLVM 之类的先进很多。但是由于是商业软件,这些算法一直被作为机密没有发表。

另外一些函数式语言也能生成高效的代码,比如 OCaml。在一次程序语言暑期班上,Cornell 的 Robert Constable 教授讲了一个故事,说是他们用 OCaml 重新实现了一个系统,结果发现 OCaml 的实现比原来的 C 语言实现快了 50 倍。经过 C 语言的那个小组对算法多次的优化,OCaml 的版本还是快好几倍。这里的原因其实在于两方面。第一是因为函数式语言把程序员从底层细节中解脱出来,让他们能够迅速的实现和修改自己的想法,所以他们能够迅速的找到更好的算法。第二是因为 OCaml 有高效的编译器实现,使得它能生成很好的代码。

从上面的例子,你也许已经可以看出,其实接近底层的语言不一定速度就快。因为编译器这种东西其实可以有很高级的智能,甚至可以超越任何人能做到的底层优化。但是编译器还没有发展到可以代替人来制造算法的地步(虽然有些技术,比如 supercompilation,有可能自动生成新的算法)。所以现在人需要做的,其实只是设计和优化自己的高层算法。


学习 1.5 种函数式语言

那么我推荐什么样的语言呢?虽然我不是函数式语言的狂热分子,但是我觉得相对而言,函数式的语言相对来说更适合入门者。因为它们不但让人专注于算法和对问题的解决,而且没有面向对象语言那些思维的限制。那么现在的问题是,哪一种函数式语言。这是一个很难回答的问题,因为没有一种函数式语言拥有所有的优点,而它们的狂热分子们经常把缺点也说成是优点,结果你还是会被误导。所以我觉得,初学者最好学习两种函数式语言。不要被我吓倒了,你并不需要学习这些语言的所有细枝末节,而只需要学习最精华的部分。所有剩余的细节,会在实际使用中很容易的被填补上。因为你没必要学习它们的全部,所以我称之为"1.5种"函数式语言。我后面会提一下哪些是精华的,哪些是最开头没必要学的。

其实真正严格意义上的函数式语言不多。最可信而又广泛使用的的函数式语言是 Scheme, Haskell, OCaml,SML, Clean 等。就我的观点,首先可以从 Scheme 入门,然后学习一些 Haskell (但不是全部),之后其它的也就触类旁通了。我不推荐 OCaml 和 SML,因为它们的类型系统里面有很多不成熟的设计,导致你需要记住太多不必要的东西。

从 Scheme(而不是 Haskell)作为入门的第一步,是因为:

  1. Scheme 没有像 Haskell 那样的静态类型系统 (static type system)。并不是说静态类型不好,但是我不得不说,Haskell 那样的静态类型系统,还远远没有发展到可以让人可以完全的写出符合事物本质的程序来。比如,一些重要的概念比如 Y combinator,没法用 Haskell 直接写出来。当然你可以在 Haskell 里面使用作用类似 Y combinator 的东西(比如 fix,或者利用它的 laziness),但是这些并不揭示递归的本质,你只是在依靠 Haskell 已经实现的递归来进行递归,而不能实际的体会到递归是如何产生的。而用 Scheme,你可以轻松的写出 Y combinator,并且实际的投入使用。
  2. Scheme 不需要 monad。Haskell是一个"纯函数式" (purely functional) 的语言,所有的"副作用"(side-effect),比如打印字符到屏幕,都得用一种深奥而偏僻的概念叫 monad 实现。这种概念其实并不是本质的,它所有的功能都可以通过"状态传递" (state passing) 来实现。通过写状态传递程序,你可以清楚的看到 monad 的本质。可以说 monad 是 Haskell 的一个"设计模式"。过早的知道这个东西,并不有助于理解函数式程序设计的本质。

那么为什么又要学 Haskell?那是因为 Haskell 含有 Scheme 缺少的一些东西,并且没有 Scheme 设计上的一些问题。比如:

  1. 缺少模式匹配:Scheme 没有一个标准的,自然的模式匹配 (pattern matching) 系统,而 Haskell 的模式匹配是一个优美的实现。
  2. 类型模糊:比如 Scheme 把所有不是 #f (false)的值都作为 true,这是不对的。Haskell 里面的 Boolean 就只有两个值:True 和 False。Scheme 程序员声称这样可以写出简洁的代码,因为 (or x y z) 可以返回一个具体的,而不只是一个布尔变量。但是就为了在少数情况下可以写出短一点的代码,是否值得付出如此沉痛的代价?我看到这个设计带来了很多无需有的问题。
  3. 宏系统:宏 (macro) 通常被认为是 Lisp 系列语言的一个重要优点。但是我要指出的是,它们并不是必要的,至少对于初学者是这样。其实如果一个语言的语义设计好了,你会几乎不需要宏。因为宏的本质是让程序员可以自己修改语言的设计,添加新的构造。可是宏的主要缺点是,它把改变语言这种极其危险的"权力"给人滥用了。其实只有极少数的人具有改变一个语言所需的智慧和经验。如果让普通程序员都能使用宏,那么程序将变得非常难以理解。所以最开头其实不需要学习宏的使用,也不必为略过这个东西而产生负罪感。等你进步到可以设计自己的程序语言,你自然会明白宏是什么东西。

(注意,这些是我自己的观点,并不代表 Scheme 设计者们的观点。)


推荐的书籍

The Little Schemer我觉得 Dan Friedman 的 The Little Schemer (TLS) 是最好,最精华的编程入门教材。它的前身叫《The Little Lisper》。很多资深的程序语言专家都是从这本书学会了 Lisp。虽然它叫 "The Little Schemer",但它并不使用 Scheme 所有的功能,而是忽略了上面提到的 Scheme 的毛病,直接进入最关键的主题:递归和它的基本原则。在第九章,你会学到如何从无到有推导出 Y combinator。我做过一个幻灯片,演示的就是这里的推导过程。这本书不但很薄,很精辟,而且相对于其他编程书籍非常便宜(在美国才卖 $23)。

SICPThe Little Schemer 其实是比较难的读物,所以我建议把它作为下一步精通的读物。Structure and Interpretation of Computer Programs 比较适合作为第一本教材。但是我需要提醒的是,你最多只需要看完第三章。因为从第四章开始,作者开始实现一个 Scheme 解释器,但是作者的实现并不是最好的方式。你可以从别的地方更好的学到这些东西。具体在哪里学,我还没想好(也许我自己写个教学也说不定)。不过也许你可以看完 SICP 第一章之后就可以开始看 TLS

A Gentle Introduction to Haskell对于 Haskell,我最开头看的是 A Gentle Introduction to Haskell,因为它特别短小。当时我已经会了 Scheme,所以不需要再学习基本的函数式语言的东西。我从这个文档学到的只不过是 Haskell 对于类型和模式匹配的概念。Real World Haskell 是一本流行的教材,但是它试图包罗万象,所以很多地方过于冗长。最根本的函数式编程概念,还是 TLS 讲的透彻。


过度到面向对象语言

那么如果从函数式语言入门,如何过渡到面向对象语言呢?毕竟大部分的公司用的是面向对象语言。如果你真的学会了函数式语言,你真的会发现面向对象语言已经易如反掌。函数式语言的设计比面向对象语言简单和强大很多,而且几乎所有的函数式语言教材(比如 SICP)都会教你如何实现一个面向对象系统。你会深刻的看到面向对象的本质以及它存在的问题,所以你会很容易的搞清楚怎么写面向对象的程序,并且会发现一些窍门来避开它们的局限。你会发现,即使在实际的工作中必须使用面向对象语言,也可以避免面向对象的思维方式,因为面向对象的思想带来的大部分是混乱和冗余。


深入底层

那么是不是完全不需要学习底层呢?当然不是。但是一开头就学习底层硬件,就会被纷繁复杂的硬件设计蒙蔽头脑,看不清楚本质上简单的原理。

在学会高层的语言之后,可以进行语义学编译原理的学习。简言之,语义学 (semantics) 就是研究程序的符号表示如何对机器产生"意义",通常语义学的学习包含 lambda calculus 和各种解释器的实现。编译原理 (compilation) 就是研究如何把高级语言翻译成低级的机器指令。编译原理其实包含了计算机的组成原理,比如二进制的构造和算术,处理器的结构,内存寻址等等。但是结合了语义学和编译原理来学习这些东西,会事半功倍。因为你会直观的看到为什么现在的计算机系统会设计成这个样子:为什么处理器里面有寄存器(register),为什么需要堆栈(stack),为什么需要堆(heap),它们的本质是什么。这些甚至是很多硬件设计者都不明白的问题,所以它们的硬件里经常含有一些没必要的东西。因为他们不理解语义,所以经常不明白他们的硬件到底需要哪些部件和指令。但是从高层语义来解释它们,就会揭示出它们的本质,从而可以让你明白如何设计出更加优雅和高效的硬件。

这就是为什么一些程序语言专家后来也开始设计硬件。比如 Haskell 的创始人之一 Lennart Augustsson,后来设计了 BlueSpec,一种高级的硬件描述语言,可以 100% 的合成 (synthesis) 为硬件电路。Scheme 也被广泛的使用在硬件设计中,比如 Motorola 和 Cisco,它们都是 Chez Scheme 的用户。


这基本上就是我对程序语言入门的建议。我可能还会修改其中一些内容。有问题的话欢迎发邮件到我的信箱:shredderyin@gmail.com。谢谢大家。


  青春就应该这样绽放  游戏测试:三国时期谁是你最好的兄弟!!  你不得不信的星座秘密


可从此处完成的操作:


Dan Friedman 的故事 (3)——miniCoq


小小才子 通过 Google 阅读器发送给您的内容:


于 12-6-11 通过 当然我在扯淡 作者:王垠

你永远想象不到 Dan Friedman 的思想的极限在哪里。当你认为他是一个函数式语言专家的时候,他发明了 miniKanren,一种逻辑式编程语言 (logic programming language),并且写出 《The Reasoned Schemer》,用于教授逻辑编程。当你认为他不懂类型系统的时候,他开始捣鼓最尖端的 Martin-Löf 类型理论,并且开始设计机器证明系统。而他做这些,完全是出于自己的兴趣。他从来不在乎别人在这个方向已经做到了什么程度,却经常能出乎意料的简化别人的设计。

有一次系里举办教授们的"闪电式演讲"(lightening talk),每位教授只有5分钟时间上去介绍自己的研究。轮到 Friedman 的时候,他慢条斯理的走上去,说:"我不着急。我只有几句话要说。我不知道我能不能拖够5分钟……"大家都笑了。他接着说:"我现在最喜欢的东西是 Curry-Howard correspondence 和定理证明。我觉得现在的机器证明系统太复杂了,比如 Coq 有 nnnnn 行代码。我想在 x 年之内,简化 Coq,得到一个 miniCoq……"

miniCoq... 听到这个词全场都笑翻了。为什么呢?自己去联想,往歪处想  从此,"Dan Friedman 的 miniCoq" 成为了 IU 的程序语言学生茶余饭后的笑话。

但是他没有吹牛,他总是说到做到。他已经写出一个简单的定理证明工具叫 JBob(迫于社会舆论压力,不能叫 miniCoq),而且正在写一本书叫 《The Little Prover》,用来教授最重要的定理证明思想。他开始在 C311 上给本科生教授这些内容。我看了那本书的初稿,获益至深,那是很多 Coq 的教材都不涉及的最精华的道理。它不仅教会我如何使用定理证明系统,而且教会了我如何设计一个定理证明系统。我对他说:"你总是有新的东西教给我们。每隔两年,我们就得重新上一次你的课!"

  青春就应该这样绽放  游戏测试:三国时期谁是你最好的兄弟!!  你不得不信的星座秘密


可从此处完成的操作:


2012年6月3日星期日

Lisp的永恒之道

Lisp的永恒之道:
感谢 Todd投递本文 – 微博帐号:weidagang

Lisp之魅

长久以来,Lisp一直被许多人视为史上最非凡的编程语言。它不仅在50多年前诞生的时候带来了诸多革命性的创新并极大地影响了后来编程语言的发展,即使在一大批现代语言不断涌现的今天,Lisp的诸多特性仍然未被超越。当各式各样的编程语言摆在面前,我们可以从运行效率、学习曲线、社区活跃度、厂商支持等多种不同的角度进行评判和选择,但我特别看中的一点在于语言能否有效地表达编程者的设计思想。学习C意味着学习如何用过程来表达设计思想,学习Java意味着学习如何用对象来表达设计思想,而虽然Lisp与函数式编程有很大的关系,但学习Lisp绝不仅仅是学习如何用函数表达设计思想。实际上,函数式编程并非Lisp的本质,在已经掌握了lambda、高阶函数、闭包、惰性求值等函数式编程概念之后,学习Lisp仍然大大加深了我对编程的理解。学习Lisp所收获的是如何“自由地”表达你的思想,这正是Lisp最大的魅力所在,也是这门古老的语言仍然具有很强的生命力的根本原因。

Lisp之源

Lisp意为表处理(List Processing),源自设计者John McCarthy于1960年发表的一篇论文《符号表达式的递归函数及其机器计算》。McCarthy在这篇论文中向我们展示了用一种简单的数据结构S表达式(S-expression)来表示代码和数据,并在此基础上构建一种完整的语言。Lisp语言形式简单、内涵深刻,Paul Graham在《Lisp之根源》中将其对编程的贡献与欧几里德对几何的贡献相提并论。

Lisp之形

然而,与数学世界中简单易懂的欧氏几何形成鲜明对比,程序世界中的Lisp却一直是一种古老而又神秘的存在,真正理解其精妙的人还是少数。从表面上看,Lisp最明显的特征是它“古怪”的S表达式语法。S表达式是一个原子(atom),或者若干S表达式组成的列表(list),表达式之间用空格分开,放入一对括号中。“列表“这个术语可能会容易让人联想到数据结构中的链表之类的线形结构,实际上,Lisp的列表是一种可嵌套的树形结构。下面是一些S表达式的例子:
foo

()

(a b (c d) e)

(+ (* 2 3) 5)

(defun factorial (N)
    (if (= N 1)
        1
        (* N (factorial (- N 1)))
    )
)
据说,这个古怪的S表达式是McCarthy在发明Lisp时候所采用的一种临时语法,他实际上是准备为Lisp加上一种被称为M表达式(M-expression)的语法,然后再把M表达式编译为S表达式。用一个通俗的类比,S表达式相当于是JVM的字节码,而M表达式相当于Java语言,但是后来Lisp的使用者都熟悉并喜欢上了直接用S表达式编写程序,并且他们发现S表达式有许多独特的优点,所以M表达式的引入也就被无限期延迟了。
许多Lisp的入门文章都比较强调Lisp的函数式特性,而我认为这是一种误导。真正的Lisp之门不在函数式编程,而在S表达式本身,Lisp最大的奥秘就藏在S表达式后面。S表达式是Lisp的语法基础,语法是语义的载体,形式是实质的寄托。“S表达式”是程序的一种形,正如“七言”是诗的一种形,“微博”是信息的一种形。正是形的不同,让微博与博客有了质的差异,同样的道理,正是S表达式让Lisp与C、Java、SQL等语言有了天壤之别。

Lisp之道

一门语言能否有效地表达编程者的设计思想取决于其抽象机制的语义表达能力。根据抽象机制的不同,语言的抽象机制形成了面向过程、面向对象、函数式、并发式等不同的范式。当你采用某一种语言,基本上就表示你已经“面向XXX“了,你的思维方式和解决问题的手段就会依赖于语言所提供的抽象方式。比如,采用Java语言通常意味着采用面向对象分析设计;采用Erlang通常意味着按Actor模型对并发任务进行建模。
有经验的程序员都知道,无论是面向XXX编程,程序设计都有一条“抽象原则“:What与How解耦。但是,普通语言的问题就在于表达What的手段非常有限,无非是过程、类、接口、函数等几种方式,而诸多领域问题是无法直接抽象为函数或接口的。比如,你完全可以在C语言中定义若干函数来做到make file所做的事情,但C代码很难像make file那样声明式地体现出target、depends等语义,它们只会作为实现细节被淹没在一个个的C函数之中。采用OOP或是FP等其它范式也会遇到同样的困难,也就是说make file语言所代表的抽象维度与面向过程、OOP以及FP的抽象维度是正交的,使得各种范式无法直接表达出make file的语义。这就是普通语言的“刚性”特征,它要求我们必须以语言的抽象维度去分析和解决问题,把问题映射到语言的基本语法和语义。
更进一步,如果仔细探究这种刚性的根源,我们会发现正是由于普通语言语法和语义的紧耦合造成了这种刚性。比如,C语言中printf(“hello %s”, name)符合函数调用语法,它表达了函数调用语义,除此之外别无他义;Java中interface IRunnable { … }符合接口定义语法,它表达了接口定义语义,除此之外别无他义。如果你认为“语法和语义紧耦合“是理所当然的,看不出这有什么问题,那么理解Lisp就会让你对此产生更深的认识。
当你看到Lisp的(f a (b c))的时候,你会想到什么?会不会马上联想到函数求值或是宏扩展?就像在C语言里看到gcd(10, 15)马上想到函数调用,或者在Java里看到class A马上想到类定义一样。如果真是这样,那它就是你理解Lisp的一道障碍,因为你已经习惯了顺着语言去思考,总是在想这一句话机器怎么解释执行?那一句话又对应语言的哪个特性?理解Lisp要反过来,让语言顺着你,Lisp的(f a (b c))可以是任何语义,完全由你来定,它可以是函数定义、类定义、数据库查询、文件依赖关系,异步任务的执行关系,业务规则 …
下面我准备先通过几个具体的例子逐步展示Lisp的本质。需要说明的是,由于Lisp的S表达式和XML的语法形式都是一种树形结构,在语义表达方面二者并无本质的差别。所以,为了理解方便,下面我暂且用多数人更为熟悉的XML来写代码,请记住我们可以很轻易地把XML代码和Lisp代码相互转换。
首先,我们可以轻易地用XML来定义一个求两个数最大公约数的函数:
<func name='gcd' return_type='int'>
        <params>
            <a type='int'/>
            <b type='int'/>
        </params>
        <body>
            <if>
               <equals>
                   <a/>
                   <int>0</int>
               </equals>
            </if>
            <then>
                <return><b/></return>
            </then>
            <else>
                <return>
                    <gcd>
                        <modulo><b/><a/></modulo>
                        <a/>
                    </gcd>
                </return>
            </else>
        </body>
    </func>
其次,我们可以用它来定义类:
<class name="Computer">
        <field access="private" type="MainBoard" name="main-board" />
        <field access="private" type="CPU" name="cpu" />
        <field access="private" type="Memory" name="memory" />

        <method access="public" return_type="boolean" name="powerOn" />
            <params>...</params>
            <body>...</body>
        </method>

        <method access="public" return_type="boolean" name="powerOff" />
            <params>...</params>
            <body>...</body>
        </method>
    </class>
还可以轻易地用它来编写关系查询:
<sql>
    <select>
        <column name="employees.id" />
        <column name="bonus.amount" />
    </select>
    <from>
        <table name="employees" />
        <table name="bonus" />
    </from>
    <where>
        <equals>
            <column name="employees.id" />
            <column name="bonus.employee_id" />
        </equals>
    </where>
</sql>
还可以用它来实现类似make file的自动化构建(语法取自ant):
<project name="MyProject" default="dist" basedir=".">
        <property name="src" location="src"/>
        <property name="build" location="build"/>
        <property name="dist"  location="dist"/>

        <target name="init">
            <mkdir dir="${build}"/>
        </target>

        <target name="compile" depends="init" description="compile the source " >
            <javac srcdir="${src}" destdir="${build}"/>
        </target>

        <target name="dist" depends="compile" description="generate the distribution" >
            <mkdir dir="${dist}/lib"/>
            <jar jarfile="${dist}/lib/MyProject-${DSTAMP}.jar" basedir="${build}"/>
        </target>

        <target name="clean" description="clean up" >
            <delete dir="${build}"/>
            <delete dir="${dist}"/>
        </target>
    </project>
一口气举了这么多个例子,目的在于用XML这种树形结构来说明Lisp的S表达式所能够描述的语义。不知道你是否发现了S表达式和XML这种树形语法在语义构造方面有着特别的“柔性”?我们可以轻易地用它构造出函数、变量、条件判断语义;类、属性、方法语义;可以轻易地构造出关系模型的select、where语义;可以轻易地构造出make的target、depends语义,等等数不清的语义。在普通语言里,你可以定义一个函数、一个类,但你无法为C语言增加匿名函数特性,也没法给Java语言加上RAII语义,甚至连自己创造一个foreach循环都不行,而自定义语义意味着在Lisp之上你创造了一门语言!不管是面向过程,面向对象,函数式,还是关系模型,在Lisp里统统都变成了一种DSL,而Lisp本身也就成了一种定义语言的语言,即元语言(Meta Language)。
Lisp的柔性与S表达式有着密切的关系。Lisp并不限制你用S表达式来表达什么语义,同样的S表达式语法可以表达各种不同领域的语义,这就是语法和语义解耦。如果说普通语言的刚性源于“语法和语义紧耦合”,那么Lisp的柔性正是源于“语法和语义解耦”!“语法和语义解耦”使得Lisp可以随意地构造各种领域的DSL,而不强制用某一种范式或是领域视角去分析和解决问题。本质上,Lisp编程是一种超越了普通编程范式的范式,这就是Lisp之道:面向语言编程(LOP, Language Oriented Programming)。Wikipedia上是这样描述LOP的:
Language oriented programming (LOP) is a style of computer programming in which, rather than solving problems in general-purpose programming languages, the programmer creates one or more domain-specific languages for the problem first, and solves the problem in those languages … The concept of Language Oriented Programming takes the approach to capture requirements in the user’s terms, and then to try to create an implementation language as isomorphic as possible to the user’s descriptions, so that the mapping between requirements and implementation is as direct as possible.
LOP范式的基本思想是从问题出发,先创建一门描述领域模型的DSL,再用DSL去解决问题,它具有高度的声明性和抽象性。SQL、make file、CSS等DSL都可以被认为是LOP的具体实例,下面我们再通过两个常见的例子来理解LOP的优势。
例1:在股票交易系统中,交易协议定义若干二进制的消息格式,交易所和客户端需要对消息进行编码和解码。
消息格式是一种抽象的规范,本身不对语言做任何的限制,你可以用C,C++,Java,或者Python。普通的实现方式是按照消息格式规范,在相应的语言中定义消息结构,并编写相应的编解码函数。假设为一个消息定义结构和实现编解码函数的工作量为M,不同消息类型的数量为N,这种方式的工作量大致为M*N。也就是说每增加一种消息类型,就需要为该消息定义结构,实现编解码函数,引入bug的可能性当然也和M*N成正比。如果仔细观察不难发现,各个消息结构其实是高度类似的,编解码函数也大同小异,但是普通语言却找不到一种抽象机制能表达这种共性,比如,我们无法通过面向对象的方法定义一个基类把消息结构的共性抽象出来,然后让具体的消息去继承它,达到复用的目的。这正是由于普通语言的抽象维度限制所致,在普通语言中,你只能从函数、接口等维度对事物进行抽象,而恰好消息格式共性所在的维度与这些抽象维度并不匹配。
其实,不同消息类型的共性在于它们都具有相同的领域语义,比如:“某字段内容是另一个字段内容的md5码”就是一种消息格式的领域语义,这种领域语义是OOP的抽象机制无法描述的。LOP的思路是先创建一门消息定义DSL,比如,类似Google的Protocol Buffer,Android的AIDL。然后,通过DSL编写消息定义文件,直接声明式地描述消息的结构特征,比如,我们可以声明式地描述“某字段内容是另一个字段内容的md5码”。我们还需要为DSL开发编译器用于生成C、Java等通用语言的消息定义和编解码函数。
有了消息定义DSL和编译器之后,由于DSL编写消息定义是一种高度声明式的编程方法,每增加一种消息的只需要多编写一个消息定义文件而已,工作量几乎可以忽略不计。所有的工作量都集中在编译器的开发上,工作量是一个常数C,与消息的数量没有关系;质量保证方面也只需要关注编译器这一点,不会因为增加新的消息类型而引入bug。
例2:在图书管理系统中,需要支持在管理界面上对书籍、学生、班级等各种实体进行管理操作。
如果按传统的三层架构,一般需要在后端程序中为每一种实体定义一个类,并定义相应的方法实现CRUD操作,与之相应的,还需要在前端页面中为每一个实体编写相应的管理页面。这些实体类的CRUD操作都是大同小异的,但细节又各不相同,虽然我们很想复用某些共同的设计实现,但OOP所提供的封装、继承、多态等抽象机制不足以有效捕获实体之间的共性,大量的代码还是必须放在子类中来完成。比如,Student和Book实体类的实现非常相似,但是如果要通过OOP的方式去抽象它们的共性,得出的结果多半是Entity这样的大而空的基类,很难起到复用的效果。
其实,不同实体之间的共性还是在于它们具有相同的领域语义,比如:实体具有属性,属性具有类型,属性具有取值范围,属性具有可读取、可编辑等访问属性,实体之间有关联关系等。LOP方法正是直接面向这种领域语义的。采用LOP方法,我们并不需要为每一个实体类单独编写CRUD方法,也不需要单独编写管理页面,只需要定义一种DSL并实现其编译器;然后,用DSL声明式地编写实体描述文件,去描述实体的属性列表,属性的类型、取值范围,属性所支持的操作,属性之间的关系和约束条件等;最后,通过这个实体描述文件自动生成后端的实体类和前端管理页面。采用LOP,不论前后端采用何种技术,Java也好,C#也好,JSP也好,ASP.NET也好,都可以自动生成它们的代码。采用LOP的工作量和质量都集中在DSL的设计和编译器的开发,与实体的数量无关,也就是说,越是庞大的系统,实体类越多越是能体现LOP的优势。
通过上面两个小例子我们可以感受到,LOP是一种面向领域的,高度声明式的编程方式,它的抽象维度与领域模型的维度完全一致。LOP能让程序员从复杂的实现细节中解脱出来,把关注点集中在问题的本质上,从而提高编程的效率和质量。
接下来的问题是如果需要为某领域设计DSL,我们是应该发明一门类似SQL这样的专用DSL呢,还是用XML或S表达式去定义DSL呢?它们各有何优缺点呢?
我认为采用XML或S表达式定义DSL的优点主要有:1) SQL、make file、CSS等专用DSL都只能面向各自的领域,而一个实际的领域问题通常是跨越多个领域的,有时我们需要将不同领域融合在一起,但是由于普通语言的刚性,多语言融合通常会是一件非常困难的事情,而XML和S表达式语法结构的单一性和“代码及数据”的特点使得跨领域融合毫无障碍。2) 在为DSL开发编译器或解释器的方面,二者难度不同。对XML和S表达式定义的DSL进行语法分析非常简单,相比之下,对SQL这样的专用DSL进行语法分析,虽然可以借助Lex、Yacc、ANTLR等代码生成工具,但总的来讲复杂度还是要明显高一些。
当然,XML和S表达式的优点也正好是其缺点,由于XML和S表达式的语法形式是固定的,不能像专用DSL那样自由地设计语法。所以,一般来讲专用DSL的语法显得更加简洁。换句话说,XML和Lisp其实是在语法和语义间做了一个交换,用语法的限制换来了语义的灵活。

Lisp之器

接下来我们继续探讨DSL的解释执行问题。DSL代码的解释执行一般分为3种典型的方式:1) 通过专门的解释器解释执行;2) 编译生成其他语言的代码,再通过其他语言的解释器解释执行(或编译运行);3) 自解释。比如,第1类的代表是SQL,上一节举的两个例子都属于第2类,而第3类自解释正是Lisp的特色。
为了理解自解释,我们可以先从内部DSL的解释执行说起。内部DSL是指嵌入在宿主语言中的DSL,比如,Google Test单元测试框架定义了一套基于流畅接口(Fluent Interface)的C++单元测试DSL。从语义构造的角度看,内部DSL直接借用宿主语言的语法定义了自己的领域语义,是一种语法和语义解耦;从解释执行的角度看,内部DSL是随宿主语言的解释器而自动解释的,不需要像外部DSL一样开发专门的解释器,因而实现的代价很低。当然,并不是说设计内部DSL不用关心任何的解释实现,实际上,还是需要熟悉宿主语言的特性,并利用该特性使得DSL能随着宿主语言的解释器得到解释执行。
Lisp拥有强大的自解释特性,这得益于独一无二的Lisp之器:宏 (macro)。宏使得Lisp编写的DSL可以被Lisp解释器直接解释执行,这在原理上与内部DSL是相通的,只是内部DSL一般是利用宿主语言的链式调用等特性,通常形式简陋,功能有限,而Lisp的宏则要强大和灵活得多。
C语言中也有宏的概念,不过Lisp的宏与C语言的宏完全不同,C语言的宏是简单的字符串替换。比如,下面的宏定义:
#define square(x) (x*x)
square(1+1)的期望结果是4,而实际上它会被替换成(1+1*1+1),结果是3。这个例子说明,C语言的宏只在预编译阶段进行简单的字符串替换,对程序语法结构缺乏理解,非常脆弱。Lisp的宏不是简单的字符串替换,而是一套完整的代码生成系统,它是在语法解析的基础上把Lisp代码从一种形式转换为另一种形式,本质上起到了普通语言编译器的作用。不同的是,普通编译器是把一种语言的代码转换为另一种语言的代码,比如,Java编译器把Java代码转换成Java字节码;而Lisp宏的输入和输出都是S表达式,它本质上是把一种DSL转换为另一种DSL。下面的例子是宏的一个典型用法。
例3:假设Lisp解释器已经具备解释执行面向过程DSL的能力,需要实现类似ant的自动化构建工具。
我们可以基于宏构建一门类ant的DSL,宏的作用是把类ant DSL通过宏展开变成面向过程的DSL,最后被Lisp解释器所解释执行。这样用Lisp编写的ant DSL就不需要被编译为其他语言,也不需要像XML的ant一样依赖于专门的解释器了。
当然,和开发专门的解释器/编译器相比,Lisp的宏也并非没有缺点,宏难以理解,开发和调试更加困难。到底是开发专门的解释器/编译器还是直接采用宏应该视具体情况而定。

总结

Lisp采用单一的S表达式语法表达不同的语义,实现了语法和语义解耦。这使得Lisp具有强大的语义构造能力,擅长于构造DSL实现面向语言编程,而宏使得Lisp具有自解释能力,让不同DSL之间的转换游刃有余。进入Lisp的世界应当从理解面向语言编程入门,这是Lisp之道,而函数式编程和宏皆为Lisp之器,以道驭器方为正途。

后记

本文是我学习Lisp的一个总结,也是写给有兴趣学习Lisp的程序员的入门资料。必须说明,我还是一个标准的Lisp初学者,几乎没有写过像样的Lisp程序,文中的错误和不足在所难免,希望读者批评指正,感谢!

参考

The Roots of Lisp
The Nature of Lisp
Why Lisp macros are cool, a Perl perspective
Wikipedia: Language-oriented programming
《实用Common Lisp编程》
《冒号课堂 – 编程范式与OOP思想》
您可能也喜欢:


编程语言汽车


基于JVM的语言正在开始流行


编程语言时间地理图


非常不错的编程技术教程


面向对象是个骗局?!


无觅

相关文章

2012年5月15日星期二

NoSQL 数据建模技术

NoSQL 数据建模技术:
全文译自墙外文章“NoSQL Data Modeling Techniques”,译得不好,还请见谅。这篇文章看完之后,你可能会对NoSQL的数据结构会有些感觉。我的感觉是,关系型数据库想把一致性,完整性,索引,CRUD都干好,NoSQL只干某一种事,但是牺牲了很多别的东西。总体来说,我觉得NoSQL更适合做Cache。下面是正文——
NoSQL 数据库经常被用作很多非功能性的地方,如,扩展性,性能和一致性的地方。这些NoSQL的特性在理论和实践中都正在被大众广泛地研究着,研究的热点正是那些和性能分布式相关的非功能性的东西,我们都知道 CAP 理论被很好地应用于了 NoSQL 系统中(陈皓注:CAP即,一致性(Consistency), 可用性(Availability), 分区容忍性(Partition tolerance),在分布式系统中,这三个要素最多只能同时实现两个,而NoSQL一般放弃的是一致性)。但在另一方面,NoSQL的数据建模技术却因为缺乏像关系型数据库那样的基础理论没有被世人很好地研究。这篇文章从数据建模方面对NoSQL家族进行了比较,并讨论几个常见的数据建模技术。
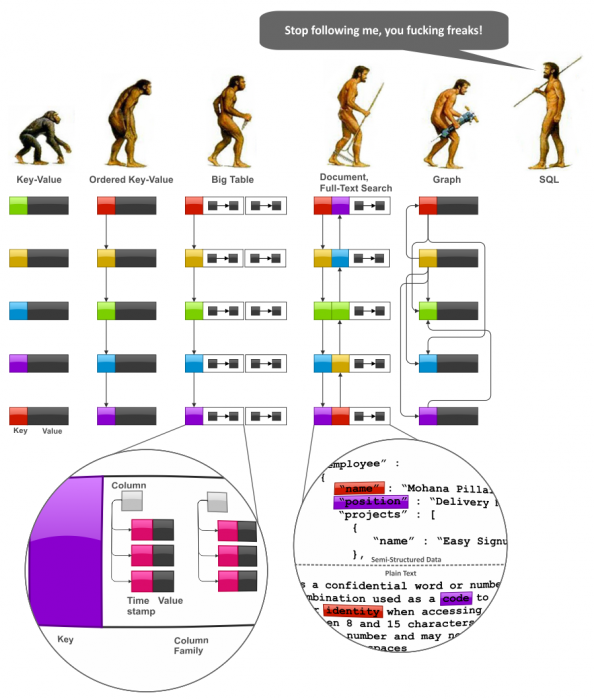
要开始讨论数据建模技术,我们不得不或多或少地先系统地看一下NoSQL数据模型的成长的趋势,以此我们可以了解一些他们内在的联系。下图是NoSQL家族的进化图,我们可以看到这样的进化:Key-Value时代,BigTable时代,Document时代,全文搜索时代,和Graph数据库时代:(陈皓注:注意图中SQL说的那句话,NoSQL再这样发展下去就是SQL了,哈哈。)


NoSQL Data Models
首先,我们需要注意的是SQL和关系型数据模型已存在了很长的时间,这种面向用户的自然性意味着:

  • 最终用户一般更感兴趣于数据的聚合显示,而不是分离的数据,这主要通过SQL来完成。
  • 我们无法通过人手工控制数据的并发性,完整性,一致性,或是数据类型校验这些东西的。这就是为什么SQL需要在事务,二维表结构(schema)和外表联合上做很多事。
另一方面,SQL可以让软件应用程序在很多情况下不需要关心数据库的数据聚合,和数据完整性和有效性进行控制。而如果我们去除了数据一致性,完整性这些东西,会对性能和分布存储有着重的帮助。正因为如此,我们才有数据模型的进化:
  • Key-Value 键值对存储是非常简单而强大的。下面的很多技术基本上都是基于这个技术开始发展的。但是,Key-Value有一个非常致命的问题,那就是如果我们需要查找一段范围内的key。(陈皓注:学过hash-table数据结构的人都应该知道,hash-table是非序列容器,其并不像数组,链接,队列这些有序容器,我们可以控制数据存储的顺序)。于是,有序键值 (Ordered Key-Value) 数据模型被设计出来解决这一限制,来从根本上提高数据集的问题。
  • Ordered Key-Value 有序键值模型也非常强大,但是,其也没有对Value提供某种数据模型。通常来说,Value的模型可以由应用负责解析和存取。这种很不方便,于是出现了 BigTable类型的数据库,这个数据模型其实就是map里有map,map里再套map,一层一层套下去,也就是层层嵌套的key-value(value里又是一个key-value),这种数据库的Value主要通过“列族”(column families),列,和时间戳来控制版本。(陈皓注:关于时间戳来对数据的版本控制主要是解决数据存储并发问题,也就是所谓的乐观锁,详见《多版本并发控制(MVCC)在分布式系统中的应用》)
  • Document databases 文档数据库 改进了 BigTable 模型,并提供了两个有意义的改善。第一个是允许Value中有主观的模式(scheme),而不是map套map。第二个是索引。 Full Text Search Engines 全文搜索引擎可以被看作是文档数据库的一个变种,他们可以提供灵活的可变的数据模式(scheme)以及自动索引。他们之间的不同点主要是,文档数据库用字段名做索引,而全文搜索引擎用字段值做索引。
  • Graph data models 图式数据库 可以被认为是这个进化过程中从 Ordered Key-Value 数据库发展过来的一个分支。图式数据库允许构建议图结构的数据模型。它和文档数据库有关系的原因是,它的很多实现允许value可以是一个map或是一个document。

 NoSQL 数据模型摘要

本文剩下的章节将向你介绍数据建模的技术实现和相关模式。但是,在介绍这些技术之前,先来一段序言:
  • NoSQL 数据模型设计一般从业务应用的具体数据查询入手,而不是数据间的关系:
    • 关系型的数据模型基本上是分析数据间的结构和关系。其设计理念是: ”What answers do I have?”
    • NoSQL 数据模型基本上是从应用对数据的存取方式入手,如:我需要支持某种数据查询。其设计理念是 ”What questions do I have?”
  • NoSQL 数据模型设计比关系型数据库需要对数据结构和算法的更深的了解。在这篇文章中我会和大家说那些尽人皆知的数据结构,这些数据结构并不只是被NoSQL使用,但是对于NoSQL的数据模型却非常有帮助。
  • 数据冗余和反规格化是一等公民。
  • 关系型数据库对于处理层级数据和图式数据非常的不方便。NoSQL用来解决图式数据明显是一个非常好的解决方案,几乎所有的NoSQL数据库可以很强地解决此类问题。这就是为什么这篇文章专门拿出一章来说明层级数据模型。
下面是NoSQL的分类表,也是我用来写这篇文章时做实践的产品:
  • Key-Value 存储: Oracle Coherence, Redis, Kyoto Cabinet
  • 类BigTable存储: Apache HBase, Apache Cassandra
  • 文档数据库: MongoDB, CouchDB
  • 全文索引: Apache Lucene, Apache Solr
  • 图数据库: neo4j, FlockDB

概念技术 Conceptual Techniques

这一节主要介绍NoSQL数据模型的基本原则。
(1) 反规格化 Denormalization
反规格化 Denormalization 可以被认为是把相同的数据拷贝到不同的文档或是表中,这样就可以简化和优化查询,或是正好适合用户的某中特别的数据模型。这篇文章中所说的绝大多数技术都或多或少地导向了这一技术。
总体来说,反规格化需要权衡下面这些东西:
  • 查询数据量 /查询IO  VS  总数据量。使用反规格化,一方面可以把一条查询语句所需要的所有数据组合起来放到一个地方存储。这意味着,其它不同不同查询所需要的相同的数据,需要放在别不同的地方。因此,这产生了很多冗余的数据,从而导致了数据量的增大。
  • 处理复杂度  VS 总数据量. 在符合范式的数据模式上进行表连接的查询,很显然会增加了查询处理的复杂度,尤其对于分布式系统来说更是。反规格化的数据模型允许我们以方便查询的方式来存构造数据结构以简化查询复杂度。
适用性: Key-Value Store 键值对数据库, Document Databases文档数据库, BigTable风格的数据库。
(2) 聚合 Aggregates
所有类型的NoSQL数据库都会提供灵活的Schema(数据结构,对数据格式的限制):
  • Key-Value Stores 和 Graph Databases 基本上来说不会Value的形式,所以Value可以是任意格式。这样一来,这使得我们可以任意组合一个业务实体的keys。比如,我们有一个用户帐号的业务实体,其可以被如下这些key组合起来: UserID_name, UserID_email, UserID_messages 等等。如果一个用户没有email或message,那么相应也不会有这样的记录。
  • BigTable 模型通过列集合来支持灵活的Schema,我们称之为列族(column family)。BigTable还可以在同一记录上出现不同的版本(通过时间戳)。
  • Document databases 文档数据库是一种层级式的“去Schema”的存储,虽然有些这样的数据库允许检验需要保存的数据是否满足某种Schema。
灵活的Schema允许你可以用一种嵌套式的内部数据方式来存储一组有关联的业务实体(陈皓注:类似于JSON这样的数据封装格式)。这样可以为我们带来两个好处。
  • 最小化“一对多”关系——可以通过嵌套式的方式来存储实体,这样可以少一些表联结。
  • 可以让内部技术上的数据存储更接近于业务实体,特别是那种混合式的业务实体。可能存于一个文档集或是一张表中。
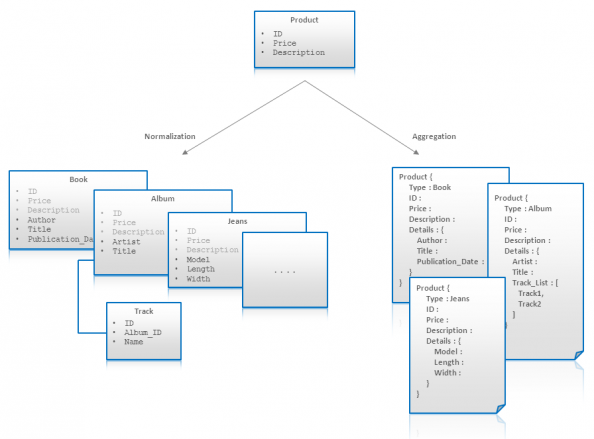
下图示意了这两种好处。图中描给了电子商务中的商品模型(陈皓注:我记得我在“挑战无处不在”一文中说到过电商中产品分类数据库设计的挑战)
  • 首先,所有的商品Product都会有一个ID,Price 和 Description。
  • 然后,我们可以知道不同的类型的商品会有不同的属性。比如,作者是书的属性,长度是牛仔裤的属性。其些属性可能是“一对多”或是“多对多”的关系,如:唱片中的曲目。
  • 接下来,我们知道,某些业务实体不可能使用固定的类型。如:牛仔裤的属性并不是所有的牌子都有的,而且,有些名牌还会搞非常特别的属性。
对于关系型数据库来说,要设计这样的数据模型并不简单,而且设计出来的绝对离优雅很远很远。而我们NoSQL中灵活的Schema允许你使用一个聚合 Aggregate (product) 可以建出所有不同种类的商品和他们的不同的属性:

Entity Aggregation
上图中我们可以比较关系型数据库和NoSQL的差别。但是我们可以看到在数据更新上,非规格化的数据存储在性能和一致性上会有很大的影响,这就是我们需要重点注意和不得不牺牲的地方
适用性: Key-Value Store 键值对数据库, Document Databases文档数据库, BigTable风格的数据库。
(3) 应用层联结 Application Side Joins
表联结基本上不被NoSQL支持。正如我们前面所说的,NoSQL是“面向问题”而不是“面向答案”的,不支持表联结就是“面向问题”的后果。表的联结是在设计时被构造出来的,而不是在执行时建造出来的。所以,表联结在运行时是有很大开销的(陈皓注:搞过SQL表联结的都知道笛卡尔积是什么东西,大可以在参看以前酷壳的“图解数据库表Joins”),但是在使用了 Denormalization 和 Aggregates 技术后,我们基本不用进行表联结,如:你们使用嵌套式的数据实体。当然,如果你需要联结数据,你需要在应用层完成这个事。下面是几个主要的Use Case:
  • 多对多的数据实体关系——经常需要被连接或联结。
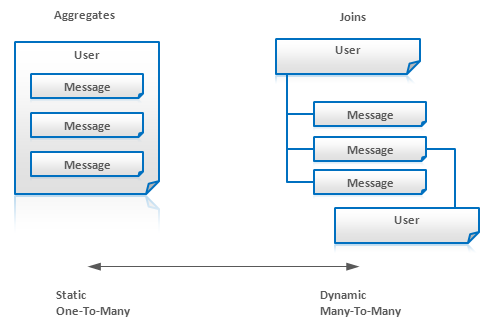
  • 聚合 Aggregates 并不适用于数据字段经常被改变的情况。对此,我们需要把那些经常被改变的字段分到另外的表中,而在查询时我们需要联结数据。例如,我们有个Message系统可以有一个User实体,其包括了一个内嵌的Message实体。但是,如果用户不断在附加 message,那么,最好把message拆分到另一个独立的实体,但在查询时联结这User和Message这两个实体。如下图:

适用性: Key-Value Store 键值对数据库, Document Databases文档数据库, BigTable风格的数据库, Graph Databases 图数据库。

通用建模技术 General Modeling Techniques

在本书中,我们将讨论NoSQL中各种不同的通用的数据建模技术。
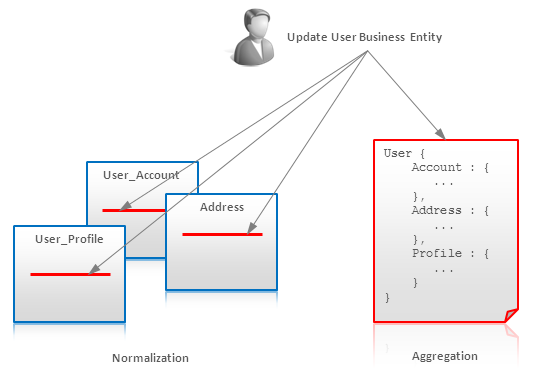
(4) 原子聚合 Atomic Aggregates
很多NoSQL的数据库(并不是所有)在事务处理上都是短板。在某些情况下,他们可以通过分布式锁技术或是应用层管理的MVCC技术来实现其事务性(陈皓注:可参看本站的“多版本并发控制(MVCC)在分布式系统中的应用”)但是,通常来说只能使用聚合Aggregates技术来保证一些ACID原则。
这就是为什么我们的关系型数据库需要有强大的事务处理机制——因为关系型数据库的数据是被规格化存放在了不同的地方。所以,Aggregates聚合允许我们把一个业务实体存成一个文档、存成一行,存成一个key-value,这样就可以原子式的更新了:


Atomic Aggregates
当然,原子聚合 Atomic Aggregates 这种数据模型并不能实现完全意义上的事务处理,但是如果支持原子性,锁,或 test-and-set 指令,那么, Atomic Aggregates 是可以适用的。
适用性Key-Value Store 键值对数据库, Document Databases文档数据库, BigTable风格的数据库。
(5) 可枚举键 Enumerable Keys
也许,对于无顺序的Key-Value最大的好处是业务实体可以被容易地hash以分区在多个服务器上。而排序了的key会把事情搞复杂,但是有些时候,一个应用能从排序key中获得很多好处,就算是数据库本身不提供这个功能。让我们来思考下email消息的数据模型:
  1. 一些NoSQL的数据库提供原子计数器以允许生一些连续的ID。在这种情况下,我们可以使用 userID_messageID 来做为一个组合key。如果我们知道最新的message ID,就可以知道前一个message,也可能知道再前面和后面的Message。
  2. Messages可以被打包。比如,每天的邮件包。这样,我们就可以对邮件按指定的时间段来遍历。
适用性Key-Value Store 键值对数据库
(6) 降维 Dimensionality Reduction
Dimensionality Reduction 降维是一种技术可以允许把一个多维的数据映射成一个Key-Value或是其它非多给的数据模型。
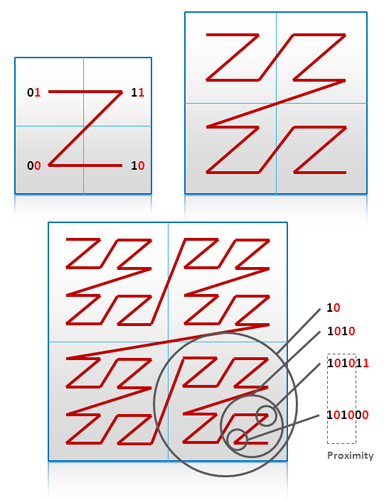
传统的地理位置信息系统使用一些如“四分树QuadTree” 或 “R-Tree” 来做地理位置索引。这些数据结构的内容需要被在适当的位置更新,并且,如果数据量很大的话,操作成本会很高。另一个方法是我们可以遍历一个二维的数据结构并把其扁平化成一个列表。一个众所周知的例子是Geohash(地理哈希)。一个Geohash使用“之字形”的路线扫描一个2维的空间,而且遍历中的移动可以被简单地用0和1来表示其方向,然后在移动的过程中产生0/1串。下图展示了这一算法:(陈皓注:先把地图分成四份,经度为第一位,纬度为第二位,于是左边的经度是0,右边的是1,纬度也一样,上面是为1,下面的为0,这样,经纬度就可以组合成01,11,00,10这四个值,其标识了四块区域,我们可以如此不断的递归地对每个区域进行四分,然后可以得到一串1和0组成的字串,然后使用0-9,b-z 去掉(去掉a, i, l, o)这32个字母进行base32编码得到一个8个长度的编码,这就是Geohash的算法)


Geohash Index
Geohash的最强大的功能是使用简单的位操作就可以知道两个区域间的距离,就像图中所示(陈皓:proximity框着的那两个,这个很像IP地址了)。Geohash把一个二维的坐标生生地变成了一个一维的数据模型,这就是降维技术。BigTable的降维技术参看到文章后面的 [6.1]。更多的关于Geohash和其它技术可以参看 [6.2] 和 [6.3]。
适用性: Key-Value Store 键值对数据库, Document Databases文档数据库, BigTable风格的数据库。
(7) 索引表 Index Table
Index Table 索引表是一个非常直白的技术,其可以你在不支持索引的数据库中得到索引的好处。BigTable是这类最重要的数据库。这需要我们维护一个有相应存取模式的特别表。例如,我们有一个主表存着用户帐号,其可以被UserID存取。某查询需要查出某个城市里所有的用户,于是我们可以加入一张表,这张表用城市做主键,所有和这个城市相关的UserID是其Value,如下所示:


Index Table Example
可见,城市索引表的需要和对主表用户表保持一致性,因此,主表的每一个更新可能需要对索引表进行更新,不然就是一个批处理更新。无论哪个方式,这都会损伤一些性能,因为需要保持一致性。
Index Table 索引表可以被认为是关系型数据库中的视图的等价物。
适用性: BigTable 数据库。
(8) 键组合索引 Composite Key Index
Composite key 键组合是一个很常用的技术,对此,当我们的数据库支持键排序时能得到极大的好处。Composite key组合键的拼接成为第二排序字段可以让你构建出一种多维索引,这很像我们之前说过的 Dimensionality Reduction 降维技术。例如,我们需要存取用户统计。如果我们需要根据不同的地区来统计用户的分布情况,我们可以把Key设计成这样的格式 (State:City:UserID),这样一来,就使得我们可以通过State到City来按组遍历用户,特别是我们的NoSQL数据库支持在key上按区查询(如:BigTable类的系统):
SELECT Values WHERE state="CA:*"
SELECT Values WHERE city="CA:San Francisco*"


Composite Key Index
适用性: BigTable 数据库。
(9) 键组合聚合 Aggregation with Composite Keys
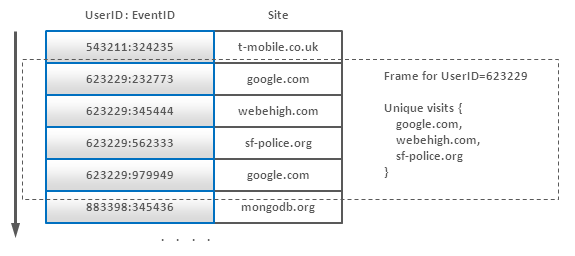
Composite keys  键组合技术并不仅仅可以用来做索引,同样可以用来区分不用的类型的数据以支持数据分组。考虑一个例子,我们有一个海量的日志数组,这个日志记录了互联网上的用户的访问来源。我们需要计算从某一网站过来的独立访客的数量,在关系型数据库中,我们可能需要下面这样的SQL查询语句:
SELECT count(distinct(user_id)) FROM clicks GROUP BY site
我们可以在NoSQL中建立如下的数据模型:


Counting Unique Users using Composite Keys
这样,我们就可以把数据按UserID来排序,我们就可以很容易把同一个用户的数据(一个用户并不会产生太多的event)进行处理,去掉那些重复的站点(使用hash table或是别的什么)。另一个可选的技术是,我们可以对每一个用户建立一个数据实体,然后把其站点来源追加到这个数据实体中,当然,这样一来,数据的更新在性能相比之下会有一定损失。
适用性: Ordered Key-Value Store 排序键值对数据库, BigTable风格的数据库。


(10) 反转搜索 Inverted Search – 直接聚合 Direct Aggregation
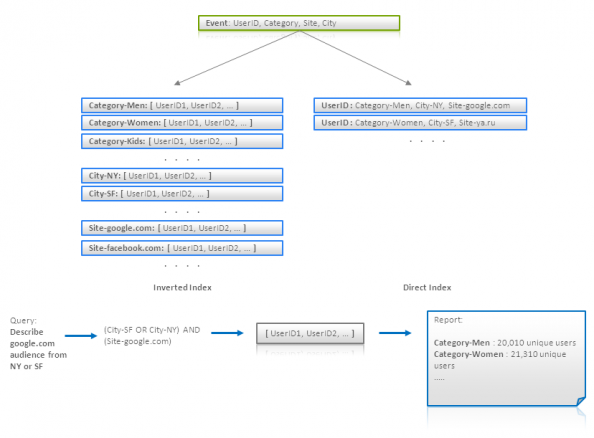
这个技术更多的是数据处理技术,而不是数据建模技术。尽管如此,这个技术还是会影响数据模型。这个技术最主要的想法是使用一个索引来找到满足某条件的数据,但是把数据聚合起需要使用全文搜索。还是让我们来说一个示例。还是用上面那个例子,我们有很多的日志,其中包括互联网用户和他们的访问来源。让我们假定每条记录都有一个UserID,还有用户的种类 (Men, Women, Bloggers, 等),以及用户所在的城市,和访问过的站点。我们要干的事是,为每个用户种类找到满足某些条件(访问源,所在城市,等)的的独立用户。
很明显,我们需要搜索那些满足条件的用户,如果我们使用反转搜索,这会让我们把这事干得很容易,如: {Category -> [user IDs]} 或 {Site -> [user IDs]}。使用这样的索引, 我们可以取两个或多个UserID要的交集或并集(这个事很容易干,而且可以干得很快,如果这些UserID是排好序的)。但是,我们要按用户种类来生成报表会变得有点麻烦,因为我们用语句可能会像下面这样
SELECT count(distinct(user_id)) ... GROUP BY category
但这样的SQL很没有效率,因为category数据太多了。为了应对这个问题,我们可以建立一个直接索引 {UserID -> [Categories]} 然后我们用它来生成报表:


Counting Unique Users using Inverse and Direct Indexes
最后,我们需要明白,对每个UserID的随机查询是很没有效率的。我们可以通过批查询处理来解决这个问题。这意味着,对于一些用户集,我们可以进行预处理(不同的查询条件)。
适用性: Key-Value Store 键值对数据库, Document Databases文档数据库, BigTable风格的数据库。

层级式模型 Hierarchy Modeling Techniques

(11) 树形聚合Tree Aggregation
树形或是任意的图(需反规格化)可以被直接打成一条记录或文档存放。
  • 当树形结构被一次性取出时这会非常有效率(如:我们需要展示一个blog的树形评论)
  • 搜索和任何存取这个实体都会存在问题。
  • 对于大多数NoSQL的实现来说,更新数据都是很不经济的(相比起独立结点来说)


Tree Aggregation
适用性: Key-Value 键值对数据库, Document Databases 文档数据库
(12) 邻接列表 Adjacency Lists
Adjacency Lists 邻接列表是一种图 – 每一个结点都是一个独立的记录,其包含了 所有的父结点或子结点。这样,我们就可以通过给定的父或子结点来进行搜索。当然,我们需要通过hop查询遍历图。这个技术在广度和深度查询,以及得到某个结点的子树上没有效率。
适用性: Key-Value 键值对数据库, Document Databases 文档数据库


(13) Materialized Paths
Materialized Paths 可以帮助避免递归遍历(如:树形结构)。这个技术也可以被认为是反规格化的一种变种。其想法是为每个结点加上父结点或子结点的标识属性,这样就可以不需要遍历就知道所有的后裔结点和祖先结点了:


Materialized Paths for eShop Category Hierarchy
这个技术对于全文搜索引擎来说非常有帮助,因为其可以允许把一个层级结构转成一个文档。上面的示图中我们可以看到所有的商品或Men’s Shoes下的子分类可以被一条很短的查询语句处理——只需要给定个分类名。
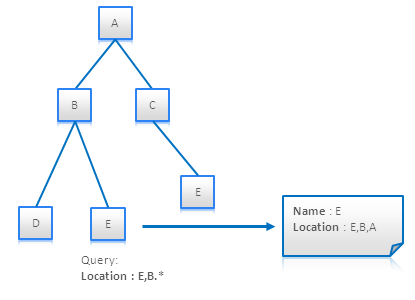
Materialized Paths 可以存储一个ID的集合,或是一堆ID拼出的字符串。后者允许你通过一个正则表达式来搜索一个特定的分支路径。下图展示了这个技术(分支的路径包括了结点本身):


Query Materialized Paths using RegExp
适用性: Key-Value 键值对数据库, Document Databases 文档数据, Search Engines 搜索引擎
(14) 嵌套集 Nested Sets
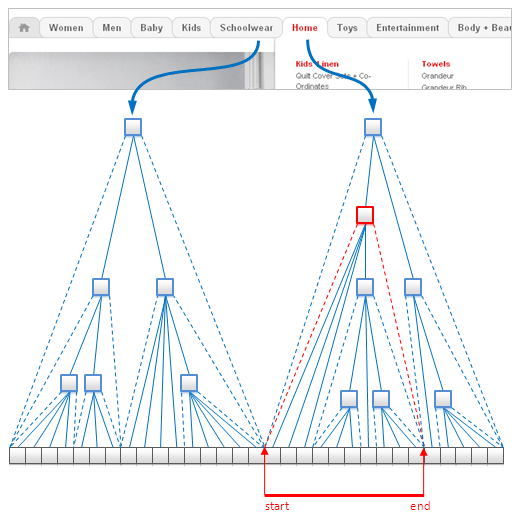
Nested sets 嵌套集是树形结构的标准技术。它被广泛地用在了关系性数据库中,它完全地适用于 Key-Value 键值对数据库 和 Document Databases 文档数据库。这个技术的想法是把叶子结点存储成一个数组,并通过使用索引的开始和结束来映射每一个非叶子结点到一个叶子结点集,就如下图所示一样:


Modeling of eCommerce Catalog using Nested Sets
这样的数据结构对于immutable data不变的数据 有非常不错的效率,因为其点内存空间小,并且可以很快地找出所有的叶子结点而不需要树的遍历。尽管如此,在插入和更新上需要很高的性能成本,因为新的叶子结点需要大规模地更新索引。
适用性: Key-Value Stores 键值数据库, Document Databases 文档数据库

(15) 嵌套文档扁平化:有限的字段名 Nested Documents Flattening: Numbered Field Names

搜索引擎基本上来说和扁平文档一同工作,如:每一个文档是一个扁平的字段和值的例表。这种数据模型的用来把业务实体映射到一个文本文档上,如果你的业务实体有很复杂的内部结构,这可能会变得很有挑战。一个典型的挑战是把一个有层级的文档映映射出来。例如,文档中嵌套另一个文档。让我们看看下面的示例:


Nested Documents Problem
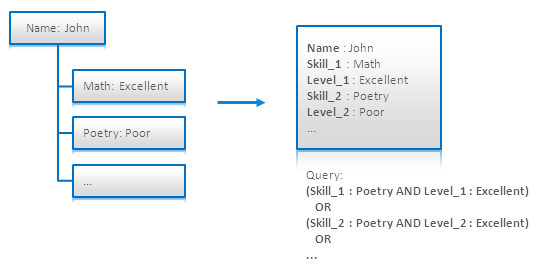
上面的每一个业务实体代码一种简历。其包括了人名和一个技能列表。我把这个层级文档映射成一个文本文档,一种方法是创建 Skill 和 Level 字段。这个模型可以通过技术或是等级来搜索一个人,而上图标注的那样的组合查询则会失败。(陈皓注:因为分不清Excellent是否是Math还是Poetry上的)
在引用中的 [4.6] 给出了一种解决方案。其为每个字段都标上数字 Skill_i 和 Level_i,这样就可以分开搜索每一个对(下图中使用了OR来遍历查找所有可能的字段):


Nested Document Modeling using Numbered Field Names
这样的方式根本没有扩展性,对于一些复杂的问题来说只会让代码复杂度和维护工作变大。
适用性: Search Engines 全文搜索
(16)嵌套文档扁平化:邻近查询 Nested Documents Flattening: Proximity Queries
在附录 [4.6]中给出了这个技术用来解决扁平层次文档。它用邻近的查询来限制可被查询的单词的范围。下图中,所有的技能和等级被放在一个字段中,叫 SkillAndLevel,查询中出现的 “Excellent” 和 “Poetry” 必需一个紧跟另一个:


Nested Document Modeling using Proximity Queries
附录 [4.3] 中讲述了这个技术被用在Solr中的一个成功案例。
适用性: Search Engines 全文搜索
(17) 图结构批处理 Batch Graph Processing
Graph databases 图数据库,如 neo4j 是一个出众的图数据库,尤其是使用一个结点来探索邻居结点,或是探索两个或少量结点前的关系。但是处理大量的图数据是很没有效率的,因为图数据库的性能和扩展性并不是其目的。分布式的图数据处理可以被 MapReduce 和 Message Passing pattern 来处理。如: 在我前一篇的文章中的那个示例。这个方法可以让 Key-Value stores, Document databases, 和 BigTable-style databases 适合于处理大图。
Applicability: Key-Value Stores, Document Databases, BigTable-style Databases

参考

Finally, I provide a list of useful links related to NoSQL data modeling:
  1. Key-Value Stores:
    1. http://www.devshed.com/c/a/MySQL/Database-Design-Using-KeyValue-Tables/
    2. http://antirez.com/post/Sorting-in-key-value-data-model.html
    3. http://stackoverflow.com/questions/3554169/difference-between-document-based-and-key-value-based-databases
    4. http://dbmsmusings.blogspot.com/2010/03/distinguishing-two-major-types-of_29.html
  2. BigTable-style Databases:
    1. http://www.slideshare.net/ebenhewitt/cassandra-datamodel-4985524
    2. http://www.slideshare.net/mattdennis/cassandra-data-modeling
    3. http://nosql.mypopescu.com/post/17419074362/cassandra-data-modeling-examples-with-matthew-f-dennis
    4. http://s-expressions.com/2009/03/08/hbase-on-designing-schemas-for-column-oriented-data-stores/
    5. http://jimbojw.com/wiki/index.php?title=Understanding_Hbase_and_BigTable
  3. Document Databases:
    1. http://www.slideshare.net/mongodb/mongodb-schema-design-richard-kreuters-mongo-berlin-preso
    2. http://www.michaelhamrah.com/blog/2011/08/data-modeling-at-scale-mongodb-mongoid-callbacks-and-denormalizing-data-for-efficiency/
    3. http://seancribbs.com/tech/2009/09/28/modeling-a-tree-in-a-document-database/
    4. http://www.mongodb.org/display/DOCS/Schema+Design
    5. http://www.mongodb.org/display/DOCS/Trees+in+MongoDB
    6. http://blog.fiesta.cc/post/11319522700/walkthrough-mongodb-data-modeling
  4. Full Text Search Engines:
    1. http://www.searchworkings.org/blog/-/blogs/query-time-joining-in-lucene
    2. http://www.lucidimagination.com/devzone/technical-articles/solr-and-rdbms-basics-designing-your-application-best-both
    3. http://blog.griddynamics.com/2011/07/solr-experience-search-parent-child.html
    4. http://www.lucidimagination.com/blog/2009/07/18/the-spanquery/
    5. http://blog.mgm-tp.com/2011/03/non-standard-ways-of-using-lucene/
    6. http://www.slideshare.net/MarkHarwood/proposal-for-nested-document-support-in-lucene
    7. http://mysolr.com/tips/denormalized-data-structure/
    8. http://sujitpal.blogspot.com/2010/10/denormalizing-maps-with-lucene-payloads.html
    9. http://java.dzone.com/articles/hibernate-search-mapping-entit
  5. Graph Databases:
    1. http://docs.neo4j.org/chunked/stable/tutorial-comparing-models.html
    2. http://blog.neo4j.org/2010/03/modeling-categories-in-graph-database.html
    3. http://skillsmatter.com/podcast/nosql/graph-modelling
    4. http://www.umiacs.umd.edu/~jimmylin/publications/Lin_Schatz_MLG2010.pdf
  6. Demensionality Reduction:
    1. http://www.slideshare.net/mmalone/scaling-gis-data-in-nonrelational-data-stores
    2. http://blog.notdot.net/2009/11/Damn-Cool-Algorithms-Spatial-indexing-with-Quadtrees-and-Hilbert-Curves
    3. http://www.trisis.co.uk/blog/?p=1287
(全文完)
您可能也喜欢:


SQL的Where语句


图解SQL的Join


【原创】SQL栏目树的代码


Web程序的最佳测试数据


几篇技术文章


无觅

相关文章

2012年4月25日星期三

当桔子遇到喝幽门螺杆菌的马歇尔

当桔子遇到喝幽门螺杆菌的马歇尔:
本文作者:桔子帮小帮主
为了给首届菠萝科学奖颁奖,大名鼎鼎的澳大利亚胃肠病学家、因发现幽门螺杆菌而获得2005年诺贝尔生理学与医学奖的巴里•马歇尔(Barry Marshall)前不久来到中国。桔子对他进行了一次专访,请他给我们讲讲,当初他一口气喝掉了幽门螺杆菌的培养液,那玩意到底什么味儿的?

【巴里·马歇尔与桔子帮小帮主的合影。】
一下是采访录音整理稿,桔子简称“桔”,巴里·马歇尔简称“马”。
双方接过名片。
桔:看不懂……韩国话。
马:哎呀我给你找个中文的。啊哈这个肯定是,here is a horse(后来我才知道他在学中文)。
桔:见到医生我很想咨询下,昨晚我胃疼来着,刚下飞机吃了个凉饭团。后来有人就跟我说,你不能吃海鲜大排档,因为是凉性的,能喝酒,因为是热的。
马:好主意。
桔:啊?
马:虽然不怎么科学……中国差不多一半人口携带幽门螺杆菌,只是他们都不知道,所以遇到胃疼,很可能是细菌作怪,下次去医院我劝你去查查,哪怕没有胃疼的时候。因为最成功的那些细菌,是那些没让携带者得病的,它们就可以持续繁衍。人类100多年前就上了这么一课,很多染上结核杆菌的人都不死,就是偶尔咳嗽,这样就把细菌传染给其他人了。只有大概5%的人死去。幽门螺杆菌可能不像结核杆菌那么差,有的甚至从某种角度来讲对人还有好处。
桔:对人有啥好处?
马:它们会略微抑制免疫系统,也许会减少过敏的概率。要是免疫系统太强,可能会积极对抗幽门螺杆菌,但也容易因此溃疡;细菌想好好在你胃里待着,最好一生都待在那儿,不惹麻烦,就要抑制你的免疫系统,这样你就不会那么容易哮喘、瘙痒。
桔:刚才你说不是所有携带者都会发病,那你喝细菌培养液的时候,你怎么知道你会是那个幸运的发病者?
马:当年不知道喝了细菌之后会发生什么,我估计好歹有一天我得溃疡,得有50%概率吧,不过估计得等好几年,我没太想会病成啥样,就是喝个试试。结果5天之后我就病得要命。从中我得到的信息是,在人体里“接种”了细菌还是可以活蹦乱跳地正常待几天,没准3天吧,然后没准会恢复,这是我从我的人体实验中学到的。多数人不知道自己什么时候感染的,因为感染的时候往往还小,小时候总会出一些稀奇古怪的状况,第一次胃难受呕吐什么的,没准就是感染上了幽门螺杆菌,然后它们就在你胃里永远住下去了。
桔:当时有没有想 ,要是没症状怎么办?研究怎么继续做?
马:我设想的状况是,细菌会在我胃里繁衍起来,不会觉得不舒服。但如果把显微镜伸到胃里,能看到很多细菌,尽管没发展成溃疡。还能看到白细胞在攻击那些细菌。这就说明疾病在胃壁里悄悄发展。这时候你不会有太多感觉,除非发展成溃疡。
桔:这就是你当时的工作假说吧?
马:对,从一个健康的胃开始,细菌入侵,白细胞作出回应,过一段时间变成溃疡。当你特别老的时候,没准变成胃癌。
桔:抗生素也不能完全杀死它们?
马:很困难,剩下一点,就可以再繁衍起来。
桔:我做科研这会儿,不是要向你挑战哦(笑),样本量是个重要因素,可你做实验怎么就用了1个样本呢?所以你的发现存在相当大的偶然性。
马:哈,我的文章很出名,世上的研究n=1的可不多,确实是小样本量。
桔:这仍旧很牛是么……
马:哈,对。问题是这就不是那么科学了,非常主观。可这件事的另一面是,研究人员在自己身上做实验,希望客观评价自己的症状,就能得到更多信息。想象一下,如果我在你身上做实验,我要先预测会看到什么症状,问你,你有这个状况吗,有那个状况吗。但你很可能有其他症状,我连想都不会想起问你。同时你也可能想,我还有这个问题,但肯定不是什么关键问题,算了别问了。可我是拿自己做实验,我就能直接思考,这个症状是由这个病导致的么,所以能得到更多细节,能作为一个很好的初步研究。第二年我们就用36个人做了实验。
桔:他们都愿意像你似的喝那个……恶心的培养液么……
马:哈哈,得给钱。不过尝起来也没那么糟。
桔:(别想蒙我)不会吧,我在实验室那会儿,恨死培养液的味儿了,尤其是煮过的。
马:对对……培养基味儿很猛,特有肉味儿。我也不喜欢。
桔:(终于承认了)那可以过滤之后再把细菌悬浮起来喝……(味道可能好点)
马:没,就从生长细菌的平皿上刮点儿新鲜幽门螺杆菌下来,搅和在鸡汤似的培养液里。差不多有20毫升。一饮而尽。尝不出细菌来,就跟喝纯培养基差不多。
桔:之前和之后需要特殊饮食么,好把它们养得舒服点儿?
马:那天早上我是没吃早饭,挺饿的。
桔:这不会让它们显得更好喝吧……
马:嗯……不过我为了让它们更容易在我胃里定居,先吃了几片西咪替丁,让胃的酸性稍微降一点。然后,看表到十点了。刮细菌,悬浮。一二三,喝吧!等了俩仨小时才吃饭。之后不需要特别照顾这帮小家伙。随后几天我特关注自己的胃,它稍微——“咔”——一叫唤,我就赶紧警觉起来。我们知道幽门螺杆菌会制造CO2、氨气、毒素,不过不是那么轻易会感觉疼,除非胃壁出现小孔,胃酸进去。过了四五天,吃了顿中餐,我喜欢中餐,面条什么的。通常我们都买很多,大家都爱吃,东一分西一分就没了。每次都吃得撑撑的。那次我可觉得不太舒服,喝点水就歇着去了。两天后的早晨,一睁眼我就吐了,吐的都是水一样的东西。细菌刚在你胃里建立起菌落的时候,会产酸,胃功能变差,食物倒是下去了,但是会囤积酸和水,连续吐了几次都是这些。我妈妈和我爱人都说我的嘴闻起来好臭。
桔:你老婆就知道了!
马:我没跟她说。
桔:当时你是不是高兴坏了,等了这么多天,症状终于等来了。
马:没。一睁眼就跟怀孕了要晨吐似的,冲到洗手间。
桔:高兴地冲到洗手间……(非要引出他的内心独白)
马:没,我还睡着呢!
“我到底怎么了,哦,我到底怎么了。”(可怜地)
“哦,我喝细菌来着……”(无奈地)
(情景重现完毕)如果这是设计周全的实验,我该在床边放个瓶子啊。而且,我可不知道这就是症状,后来做的内镜检查,我算算~周二喝的,下一个周四检查的,周五我跑到病理学实验室,好消息,好多细菌,非常严重的感染。我可激动了。
桔:(还真严谨,确定了才开始高兴)你咋知道能治好呢?
马:我用的菌株,是从我一个病人身上取的,我刚用某种抗生素把他给治好了,而且在细菌上测试过了各种抗生素的效果。所以我是有一定把握。
桔:多大了当时?
马:32。
桔:意气风发啊,是不是年轻才敢这么做?
马:(想了想)现在主要是我的事儿太多了。
桔:不能轻易让自己特别病。
马:当年做事不考虑后果,后果来了再担心也不迟。我就总跟我老婆说,给我原谅比给我许可要简单。刚才不是说周五看到结果了吗,我就算计着下一个周二要做更多详细实验,就得跟她说了,当然我得等着,趁她情绪好的时候说。她对我表达了些许的怜悯,和极大的担心,怕传染给她和孩子们,当时对这种细菌一无所知。她让我马上吃药,我说“不要啊”,所以她跟我说你就这么再赖4天,周二完了立马吃药去,要不小心我把你踢出去。
桔:周二吃了药你顺利康复了?
马:实际上周二我已经好转了。细菌确实不容易摆脱,可在另一些人体内却待不长。我就是。细菌不怎么适应。世界上多数感染幽门螺杆菌的人,总是从小持续不断接触感染源,比如他们生活的环境到处都是污染的水源,或者家庭成员很多人是携带者。所以他们每个月都会感染新的幽门螺杆菌。加上胃的免疫系统本来就不强,又没有其他竞争者——没多少细菌愿意活在人胃里,幽门螺杆菌就找到自己舒服的地方待下去了。

【幽门螺杆菌,又名幽门螺旋菌,首先由巴里·马歇尔(Barry J. Marshall)和他的同事罗宾·沃伦(J. Robin Warren)二人发现,两人因证明幽门螺杆菌是大多数胃溃疡和胃炎的成因,而获得了 2005 年的诺贝尔生理学或医学奖。(图片:hefitrx.com)】
桔:刚才你说是用抗生素把病人治好的,那时候人们都不知道是细菌导致,你怎么能给病人开抗生素呢?
马:1983和1984那会儿,就有严重溃疡病人来找我们。当地一些家庭医生有时候也会来听我的演讲。那些大教授、专家,很多都说不相信我们的理论。可是有些家庭医生说,太有意思了,我这儿有严重病人,不如试试抗生素,于是他们就把状况最差的病人介绍给我们。于是我们就给他们检查,发现了幽门螺杆菌就用抗生素,效果往往特棒。那些家庭医生——尤其是那些思维灵活的,说你们的治疗明显有效。你可能又会说样本量也很小,但我们就是这样积少成多。而且为了客观,我们不单看症状,尤其要做活检,看到胃变正常了。这个结果最颠覆了,以前人们认为胃病和溃疡就是因为衰老,是一种自然的生命过程,没法治。我发现的一种治疗方法,就是——你在美国生活过,你肯定知道那种粉色药水Pepto Bismol,可以抑制幽门螺杆菌,不过是暂时的,并不是治愈。可如果你在粉色药水的基础上加上抗生素,1-2周就可以杀掉75%的幽门螺杆菌。
桔:你怎么发现这么奇怪的组和的?
马:哈,我思考。开玩笑的……我就琢磨,哼,那帮美国人为什么有事没事就灌点Pepto Bismol,都100年了。会不会是种抗生素?如果是,就解释了那些幽门螺杆菌携带者为什么每次不舒服就去超市买点Pepto Bismol,喝点就舒服了。有了这个假设,我们就真测了一下,发现果真细菌先消失,过一个月还会再长起来。我就加一种抗生素,发现病人就被治好了。我先拿这种方法治疗溃疡最糟糕的病人,当时所有人都说他们,该动手术。结果我只用抗生素,10个里面好了9个。你可能还会说“人数真少啊”,可其他人的治疗,10个里面好了0个或者1个。接着我就去找研究经费,最后在100个病人身上做了双盲测试。
桔:这么多年了,细菌对从前用的抗生素产生抗药性了么?
马:部分抗药性。98年、99年的时候,大家发现用抗生素组和,加上抑酸药物,就能治疗90%的幽门螺杆菌,过了10年这个比例变成80%。然后很多医生,特别是欧洲和美国医生,说以前用2种抗生素和抑酸药物,现在得用3种了,也就是更猛的治疗方法。
桔:中国人吃抗生素没那么多,是不是耐药性就没那么普遍?
马:在中国现在还未必需要。这个道理是这样的,如果一个国家所有人都使用同样的抗生素,就容易产生抗性,欧洲就是如此,那10年10%的差别就是这么来的。我们可以算算,中国恐怕有5亿人口携带幽门螺杆菌,很多人没症状,每年只有2500万人吃抗生素接受治疗。其中500万有耐药性,需要其他治疗。很大的数目了,也许对中国人口来说不算很多。
桔:耐药性或者对细菌的敏感度,和人种有关系吗?
马:没。不过中国和亚洲的幽门螺杆菌是毒力格外强的一株,按说更容易给寄主惹麻烦,尤其是胃癌。20世纪之所以有更多幽门螺杆菌病例,是因为人们更健康了,吃得更好,蛋白更多,胃里更偏酸,免疫系统更强。溃疡发病是由于白细胞和幽门螺杆菌之间的对抗(做出两手手指交叉的动作),胃里有酸,但是透不过来。但如果白细胞把上皮细胞都扒拉开想出来打细菌——“让一让,我们要从胃壁出去!”,胃壁就出现小漏洞了,胃酸就漏过去了。所以,酸的屏障,和强劲的免疫系统,二者不可兼得。免疫强了,有时候确实能把细菌都干掉,但也更容易发生溃疡。所以20世纪胃溃疡发病率上升并不是由于压力大;以前人们还饿肚子呢,营养跟不上,所以携带幽门螺杆菌也不容易发展成胃溃疡,人们活得也不长,还没来得及发展成胃癌。所以20世纪之前人们也没听说过幽门螺杆菌。当年我开始做研究的时候,澳大利亚的幽门螺杆菌携带者差不多有40%,我还能做对照。后来在日本连对照也找不到,全都有幽门螺杆菌。胃癌是日本第一癌症,他们的溃疡发病率也高,正是他们发明了内窥镜,所以幽门螺杆菌应该是他们发现才合情合理。之所以没发现,就是因为每人都是携带者,研究人员看不出这种细菌有什么了不起。要知道我们聊的可是上世纪70年代,那会儿所有日本人都携带幽门螺杆菌,没人的胃是正常的。有趣的是,70年代一些中国医生发现能用抗生素治疗胃溃疡,可他们没有内窥镜,没法做深入研究,82年的上海,有个医生的博士论文里也出现过幽门螺杆菌照片,可由于种种原因他也没能完成相关研究。
桔:我听说在你做出发现之后很多年,美国才承认?
马:一旦政府加入健康干预,就会进展缓慢,因为政府决定关系到所有人,需要更强的证据才能做决定。必须等到一个意见被所有人接受,政府才会许可。美国医生上医学院的时候,如果学到为溃疡,首先要学厚厚的一章,讲压力、吸烟导致胃溃疡,还有一章讲手术治疗,那时这是唯一手段。那些可怜的医学院学生啊!我也曾经是……“哦天啊,又是溃疡,得记那么多东西,根本就没道理。10种不同的假说……”所有都是错的,真没效率。现在所有内容都在2页纸上:溃疡,幽门螺杆菌,抗生素。复习的时候至少能省下四五天,可以去沙滩歇着了。想想美国,要是医生想用什么新疗法,没准就被告了。美国之所以有那么多诉讼,就是因为他们的保险费太高了,一旦有事发生,病人就说,把我的钱还回来!所以医生才不想在FDA引进新药之前做什么新事。临床试验、整理所有证据、开大会、发表文章、联络全国所有医生,然后医生说,现在该用抗生素了。接着就在1个月内翻天覆地。另一个大问题,FDA不负责教育,只会通知,那你怎么教20万医生?这时候就轮到药厂了,他们花上1亿美元搞个教育项目,1万个销售代表走街串巷、开大会,1个月搞定。而澳大利亚是社会化医疗,差不多10年,一切缓缓进行。美国呢,10年之间表面上啥动静也没有,突然有一天FDA说,够了,证据够了!药厂再登台。其他国家一看美国动了,纷纷效仿。
桔:澳大利亚可以给病人开没那么确定的药么?
马:你看,区别就在于,在澳大利亚每个病人都是一个实验,医生看看你说,试试这个去!
桔:要是发生了意外病人不告医生么?
马:那最好连药也别开,就不会被告了。医生不可能100%成功,所有人都知道。美国的制度还有一点不好,药厂总是受经济利益驱使的。他们不愿意把钱扔在那些能治好病的药上面——病人好了他们还赢个什么利啊。那些挣大钱的药,都是终身用药的,比如Gleevec治疗一种特殊的白血病,吃着你就正常了,死不了,但一停药就恢复得病,这对药厂来说就是“完美的药物”,所以现在Gleevec都有第二代、第三代了,产生抗药性,就继续升级吧。
(你作为一个中国记者,咋还不问我对中医的看法……)很多中国记者问我对中医怎么看,我觉得大多数没用,有些有用,可目前还没有科学证据,病人用药的时候,不知道哪种药更好,哪种药起了疗效。除非研究跟上,找出到底什么成分管用,为什么管用。那时候国家就可以为此买单了。但现在不应该,因为你不能为那些没证据、没通过双盲实验的东西买单。
桔:我觉得很多中成药是安慰剂,尤其胃药,因为有的病过一阵也会自己康复的。
马:我不相信安慰剂这回事。我觉得就是统计学问题。人人都会随机变化,去看医生的时候病症肯定是最差的,你在谷底的时候去了,医生给你点药,实际上你的状态自然就会到峰顶。
桔:有时候也是心理暗示吧,每次去医院我就觉得病好了。
马:嗯。有时候病人来了说好难受啊,我给他做了全面检查,说没事儿啊,要不你再测测血?测完血我跟他说,你没事儿啊。他平静地说,那我就放心了。
桔:哈哈。
马:还有一招很管用,就说,你这样儿的我见多了。
桔:是不是很多人一看你是诺贝尔奖得主就特别愿意找你看病。
马:没错。通常还都是疑难杂症。不过多数时候我也做不了什么神奇的事。我跟他说,你都看了5个医生了,全是某个领域的专家,我的发现和他们一样,没别的了。没准你该回去看那个医生。要想看我得等特长时间,差不多几个月才排得上,不过他们携带螺旋杆菌已经一辈子了,也不在乎多几个月。来看我的时候,其中一些都好了,另一些病情发展得更明显,当然更容易看出问题。他们就会说,马歇尔医生真是个天才!他看出了其他人都没看出的问题。不愧是诺贝尔啊。
桔:刚才你说在澳大利亚每个病人都是个实验,那目前有什么实验计划?
马:我一直都在用病人试各种新型的抗生素,有时候征求病人同意多取点组织,给细菌做基因组测序,没准能发现新基因,比如有的幽门螺杆菌不导致溃疡,有的会导致溃疡,比较两种菌的区别,就能看出到底细菌的什么基因同溃疡有关。
桔:是什么样的基因?
马:幽门螺杆菌主要分泌两种毒素,一种注入细胞,让细胞更容易漏,细菌能从细胞里偷点离子和分泌的蛋白,这种毒素在中国的菌株里100%都有,欧洲菌株中只有60%有,这就是为什么中国的病更糟糕。第二种直接在细胞上打洞,抑制免疫系统。所以刚开始细菌来了,免疫系统去攻击它,人出现明显症状,之后免疫系统把它给压下去,接着细菌去分泌、抑制,再长起来,免疫系统再上来,如此反复。是共生的过程。回头你胃里不是一颗两颗,拿胃镜一看,是一层。就跟你去看橄榄球赛,要是沙门氏菌感染,就跟球场上20个球员似的;幽门螺杆菌,你转身,看看观众。非常不同。除此之外我还在研究,怎么利用幽门螺杆菌输送疫苗,要知道多数携带者都不发病,那就很有可能让菌在人体内生长几周而和人相安无事。我们在尝试不同的菌株,看哪些不会让人得病。
桔:千万别用你那株(笑)。
马:我那个可厉害。找出合适的菌株,就可以把你想要的蛋白克隆进去,做成食物,人们可以随便喝就相当于吃药了。比如流感发病了,现在很容易找到相关基因,克隆到幽门螺杆菌里。它们就可以在你胃里建立菌落。你的免疫系统发现菌,说:“你肯定得流感了!赶紧加班造抗体!”这比传统的打针容易多了,喝一次,过2周细菌感染自然消失,但这时你已经对流感免疫了。
桔:把想要的基因克隆到幽门螺杆菌之后,它们会在表面表达你想要的蛋白,但是在胃酸里不会被降解么?
马:不会。要是用的益生菌,胃就会觉得它们都是食物,会和食物一样处理,所以要是用益生菌携带你要的蛋白,99%都被胃给消化了,不会有任何效果。幽门螺杆菌跑到你胃壁里,24小时都待在那儿;另一个原因是它们跑到粘膜层之下,免疫系统特别容易感受到它们。所以从前人们的想法是用益生菌做载体,把疫苗带入人体,结果非常难以实现,你的身体把它看成食物,直接给消化了。但用幽门螺杆菌的想法也不是那么容易实现,12个博士后工作了5年了,有的还是中国人呢。我有俩博士生就是来自成都,他们有四川地震奖学金。现在小鼠实验已经看到效果了,这证明理论至少是正确的。同时我们利用人来测试哪种细菌最合适。
桔:怎么控制剂量呢?
马:幽门螺杆菌不喜欢氧气,所以不会到处跑,身体其他地方氧气太多了,它们只待在胃里,很安全,也不用担心剂量,如果我给你1颗细菌,一周后你来看我,胃里就达到10^9了。我们能控制的是表达蛋白的剂量,还可以用不同的食物控制。这也是用幽门螺杆菌的好处,它们就相对固定在你胃里,吃下任何东西都可以路过它们对它们造成影响。要是稍微有点失去控制,只要喝点pepto bismol就可以了。但却可以在4小时之内诱导表达出90%的蛋白。比传统疫苗容易控制。
桔:回头用人做实验有什么样的规则?牵扯到什么样的伦理问题?
马:我们当然会签知情同意书。你看,美国用科研公司的问题在于,他们通常给钱,比如给个50美元让个人来做几个小时的实验,我们这种研究更复杂,那好,每天200美元你来14天。这就吸引了好多失业的、无法工作的、残疾的、流浪汉、精神疾病——你知道在美国老能见到那些疯狂的人到处跑,这些人都来参与科研,科研人员给他们签知情同意书,他们没受过教育,根本不理解那些表格都是什么意思,这才是不符合伦理的。参与我们的研究,必须至少有高中文化,另外,我们不想让人来参加实验就是为了拿钱,所以我们考察正常的工资水平,付给他们相应的金额,而不是特别高。还必须有手机,知道怎么发短信,所以如果有个老太太过来颤颤巍巍地说“我~有~手机~”,是不行的,我们通过短信沟通,比如告诉他“该吃绿的了”,他还可以给我们回复说“明天去不了,不舒服”。还得会用email,有一次我跟一个人说,别吃抗生素哦,我们在测试幽门螺杆菌,结果他回来说,我忘了跟我的医生讲了,结果我就吃抗生素了。我只好说“你运气真不怎么样,好,你现在失去资格了,出去,没钱了!”所以后来我们就用email发出各种警告,“亲爱的患者,请记得别吃抗生素,去看你的医生之前,先知会我们。(语重心长地)”一下就能通知50人。效果好多了。
桔:将来做临床实验有可能来中国么?
马:如果在人体实验活细菌,要求就严格多了。要是什么环节出了问题,没准会在中国造成传染,跑到环境里,那就糟糕了。得先做实验证明很多事情,比如做实验用的细菌离开人体就活不了、不会到处传染、不会导致溃疡或癌症。最开始总是从少数人开始,比如最开始是在我身上实验,20年来又有一些研究者在人体进行实验,7年前美国德克萨斯州似乎有30个志愿者参与了实验,德国也大约有30人参与过。我们的实验也差不多有30人参与,6个安慰剂,做这组实验的时候我们对前来的病人说,“要是幸运,没准你喝的就是鸡汤,我们还给你倒贴钱!”他们就说“哦也,希望如此”!参加我们实验的志愿者差不多拿到了2500美元,喝幽门螺杆菌之后得等上3个月,在此期间要来做3次活检,加上抽血,一共来12次。通常来一下要占用1个小时,半天就浪费了,所以每次来差不多给他们100美元,加上活检、交通费等等,所以是完全符合伦理的。
桔:你已经知道幽门螺杆菌在人体会生长,正常表达你要的蛋白,还需要在人体实验什么?我想明确知道临床实验到哪一步了。
马:你说的那些在小鼠身上做就可以,我们已经对这些问题有明确了解了。可如果想在人身上实验一个新物种,也就是GMO(Genetic modified organism,遗传修饰过的生物), 它携带一种新的表面抗原,可能会有副作用,比如免疫反应,都要考虑到。我们还没在人体测试GMO。这步需要更多钱,如果要测试对流感的免疫,要把被试关在一个特殊的地方,让他们一直不离开,因为回头你要让他们接触流感病毒。
桔:你为什么执着于喝的疫苗?估计多少年之后人们能喝上疫苗?
马:现在人都活得长了,有的疫苗是小时候注射的,50岁的时候需要追加免疫,水痘、甚至小儿麻痹症,都需要。所以针对老年人免疫将是一个市场,但大家不喜欢用针管注射,如果能把疫苗做在食物里,超市就能买到这些免疫加强剂,比如掺在酸奶里——这样疫苗的价钱还能下来,一杯牛奶多少钱,1块钱;打针却要25块。我们觉得大家会喜欢的。应该是一个巨大的市场。我希望10年后这个想法就能成真。
桔:很期待。幽门螺杆菌还有什么其他医学用途呢?
马:我们还期待利用幽门螺杆菌抑制人的免疫系统,这块市场就远没有疫苗那么大了。但正因为受众少,没准还能更快成药,就跟试验孤儿药一样,不用注册,连测试也不用做的那么透彻,患者通常会更愿意冒险尝试。
桔:我觉得中国的孤儿药研发没那么顺。
马:不会吧,我知道中国什么系统,比如已经有人在病人身上做干细胞治疗的实验了,都是非常初步和实验性的,还有外国人来。
桔:嗯,我了解你说的这种情景。但是中国很多罕见病患者没有药,因为很少有人愿意为了那么少的利润专门为他们研发。
马:美国有一种东西叫做IND,investigational new drug(临床研究用的新药),如果医生想用IND条目中的药物,就必须从每个患者身上收集信息和数据,还得有安全范围。比如你这儿收集了几个病人,他们病得要死,你觉得某种药可能管用,就给FDA写申请,90天内他们必须给你答复。唯一的顾虑是,当前这种药是不是相对安全,检查的人看看说,“嗯,看起来做了几只老鼠几只兔子实验,看起来还挺安全的,拿走试去吧。”所以一旦一种药物上了IND名录,就意味着你可以开给病人,不需要双盲实验。只要也给病人签了知情同意书。我感觉中国的机制也应该类似。
桔:你对美国的医疗和科研系统这么熟悉了,最后怎么决定要回澳大利亚的?
马:回祖国是最自然和最舒服的,你也在美国待过,你肯定明白我在说什么。英语对于你来说是第二语言,你肯定觉得特吃亏,因为你周围是完全不同的文化。我知道你在想什么,你肯定在想,哼,这个澳大利亚家伙,跑到美国去,跟澳大利亚有个什么两样。可文化差别真的存在,所以不是很舒服,也不自然,尽管弗吉尼亚州已经是美国最好待的地方了。总之如果能回到祖国,同时能继续你最想做的研究,那就是完美组合。
桔:什么样的文化差别呢?我举个我的例子吧,第一年系里总要带新学生去看Second City的脱口秀,就是一种说得特别快、聊政治调侃社会的演出。周围所有人都狂笑不止,我不知道他们在笑什么。即使明白语言,我觉得这些狗屁政治和我有个毛关系啊。
马:哈,你看,我没法选举。
桔:哈哈,对,是个重要原因。
马:从一开始我就觉得在美国生活只是暂时的,最初想只待两年,后来待了十年,开始了自己的事业。可转念一想,我们似乎不想在美国度过余生,不然回澳大利亚看一眼吧。回去一看,我们就说,“还真不赖”。现在我住的地方离我小时候住的地方只有200米,我知道我只要走200米就可以去到童年生活的地方,所以街道名称都和从前一样。同时也特别有安全感。在你自己的家园,哪怕你看不见,也知道每个人都在做什么;可是在美国,你真的不知道小山背面的人在干什么、想什么、要干什么。
桔:呵呵,我以前以为少了语言隔阂就少了文化隔阂。
马:我的美语不好,他们经常听不懂我说什么。
桔:你说的差异,是不是还包括……我想象你在澳大利亚没准还能养个马什么的,一提前澳大利亚我就想到草场。
马:没错,我有个农场,离我住的地方有100公里。80公顷,挺大的,我们自己没养牲口。不过邻居有时候在我们的地上放马。还有好多袋鼠和其他澳大利亚动物跑来跑去。
桔:你会去那儿做农活儿或者雇人种地么?
马:我就是为了锻炼身体,不种吃的。你看,现在城里人都流行在健身机上跑步,太没劲了。我特爱去农场修东西,钉个窗户、敲个房顶、修一下葡萄枝,好多事儿好干。科研圈儿可没锻炼身体什么事儿。刚才你提到在不同的文化中生活。我感觉有时候美国人做的事,你在中国或者澳大利亚,根本想也不会想,比如美国枪械自由,那么多人有枪。你会问,为什么那么多人想要一把枪呢?家里人不会被伤到么?但同时要考虑到,美国人习惯对自己负责,没有安全感。手里有枪,心中不慌——也更快乐。美国的媒体总是说负面的,但实际上如果你生活在弗吉尼亚……
桔:你也有枪么?
马:没有没有!不过我琢磨,要是我是美国人,没准我得搞把枪。
桔:我记得几年前我念书的时候,弗吉尼亚学校发生过枪击案,凶手是个韩国人……
马:对,弗吉尼亚理工,我女儿从前就住在同一个宿舍里。不过枪击发生的时候她已经走了。这个问题没有答案。允许有枪,就肯定有疯子拿着枪伤害别人。对了,我听说弗吉尼亚刚改了规矩,以前他们规定你每周只能买一把枪。
桔:你到底需要多少把枪啊,和我买牛奶频率一样。
马:后来有人说限制买枪违宪,然后就变成每天都可以买了——你也可以一天去三个店买三把枪。可同时,在弗吉尼亚和美国,犯罪率下降了!弗吉尼亚只要你没有犯罪记录就可以随身带枪在街上走,很多人觉得“疯了!灾难啊!”结果你猜怎么着,犯罪率还下降了。在街上抢个人,老招数是,“打电话叫警察!赶紧开溜!”所以你可以把他们痛打一顿,抢了钱走人;可如今,哪怕你抢个老太太,她没准掏出枪来,“乒乒乒”你就玩儿完了!做贼太危险了!所以犯罪率降下来了。没准还真是个好计策。澳大利亚你可没法这么容易就拿到枪,要是农场上到处跑袋鼠,我们想把他们干掉,得申请,人家问:“你们地上有多少袋鼠啊?”“50只,它们把野花都啃光了,还吃我们种的东西。”“哦,去杀了30只吧。”我们自己也不杀,会找专门的猎人,他过来把30只击毙拉走。
桔:(笑)听起来你并不是疯狂科学家。
马:对,我现在的事儿太多了,不可能什么都自己做。但让我高兴的是,我现在还参与到非常有创造性的那部分工作中,当然我也喜欢做具体的科研,不过那就意味着,每次有个主意,你得用6个月时间才看得到结果。现在我手下有好多人,这样我每周都可以想新主意,然后把任务交给别人。
桔:除了在实验室和看病人,其他时间干什么,有什么爱好?
马:我特别喜欢电子器件,录音机啦、计算机啦。我还喜欢攒,去上海就逛数码电子市场。遇到新鲜的东西就买。比如我特别喜欢我这根笔,其实也是录音笔。
桔:(冷汗……我都没有,早知道管你借。)
马:我还喜欢修东西,在澳大利亚我修了我爸爸的拖拉机,还有80年代的机器,实验室器械什么的,闪烁计数器、伽玛射线探测器、光谱仪……一箱一箱的。
桔:该弄个博物馆。
马:我有个朋友也特喜欢计算机、计算器这样的东西,我们琢磨过将来搞个计算机博物馆、电子博物馆之类的。修旧收音机可好玩了。我来中国,或者去其他地方,我就爱逛古董店,敛破烂。我老婆就是酿酒能手,我们自己种葡萄,也不多,一年400公斤,也就300瓶。装瓶之后我们还打印自己的标签贴在酒瓶上。
桔:啊……(好有生活品质啊)
马:我们尝尝是不是正常的味儿,挺烈的。
桔:你老婆学心理的,你们吵架的时候她是不是永远赢?
马:没错。一般单身男人想象婚姻,总是有偏差,你觉得50%差不多了吧,吵架至少得有一半你还能赢吧。最后你总是发现,你不能赢,让女人赢对你俩都好,所以一定要让女人说最后一个词。不过在我家我夫人总是正确的,这倒是没错。我相信男人和女人的思维方式不同。我夫人总爱计划,也不怎么跟我讲。她定下计划,下个小时、下一天、下周、下一年干什么。她的大脑就跟记事本似的。可我没准想着一件事,回头做的是另一件。所以有个人看着我挺好的。我和我夫人做决定总是很慎重。比如现在我们要做一个重要决定,我们要不要回澳大利亚,要找什么工作,我们找两张纸来,一边写“这个工作的具体好处是什么”,比如工资啦等等,另一张写那些无法衡量的,比如“澳大利亚是个好地方”、“我们更喜欢那儿的人”。好,现在看着一边,我觉得想弥补这些缺陷,得多给我多少钱。我们总是这么做决定的。下面再去找工作,目标就具体了,希望得到多少钱。
桔:你俩商量的方式真是俩科学家。
马:我夫人是心理学家。咱们总觉得心理学不是科学,实际上我觉得心理学是非常难的科学。要证明“我感觉好点了”或“我觉得更糟了”,可不是容易的事儿。你看市面上说是心理学的多了,但实际上真正的心理学家都特别严谨。所以两种大脑做一件事可真好。她照顾很多事情,我就可以更自由。
(就在所有人都松懈了,收拾东西准备散伙的时候,他突然静静说了一句:)
对我来说,就像从十几岁开始再没老过。It's like being an eternal teenager for me.

2012年4月14日星期六

Primitive Captcha Solving / OCR in Javascript

Primitive Captcha Solving / OCR in Javascript: Blizzard's recently concluded Diablo 3 beta key giveaway Twitter contest provides an opportunity to demonstrate primitive Captcha solving / OCR in Javascript, along with some basic use of the HTML5 canvas element, a Javascript OAuth library, and artificial neural networks.